时序数据库不是通用数据库的"变种":传统 MySQL/PG 为"事务"而生——每行一条独立记录,强调一致性;时序数据库为"指标"而生——设备在固定时间戳上不断追加的测点数据,强调高频写入、聚合查询、降采样与压缩存储。
把时序数据硬塞进 MySQL 是什么感受?10 万台设备 × 100 个测点 × 每秒 1 次 = 一天 86 亿条记录。MySQL 写到第三天就开始抖动,一年下来存储成本能吞掉整个项目预算。这就是为什么要用专门的 TSDB。
为什么工业场景对时序数据库特别苛刻?
写入吞吐:单节点要能撑得住每秒百万级写入,还要支持乱序写入与批量导入。
压缩比:传感器数据高度相关,好的 TSDB 能做到 10:1 甚至更高,存储成本天差地别。
查询性能:工业场景大量"某设备最近 N 小时所有测点"、"跨所有设备聚合某指标"这种典型时序查询,要毫秒级返回。
边云协同:产线在车间、集团有云中心,数据要在边缘本地缓存与聚合、在云端集中分析与展示。
AI 原生:PHM、质量预测、能耗优化都要直接基于时序数据做推理,TSDB 必须能接得住。
时序数据库已经从小众工具变成工业数字化的核心基础设施——据墨天轮 2026 年 7 月中国数据库流行度排行榜,TDengine 以 211.25 流行度指数在非关系型数据库中位居榜首,KaiwuDB、DolphinDB 分别以 134.47 与 76.34 紧随其后。国产厂商在这个赛道上,已经是世界级选手。
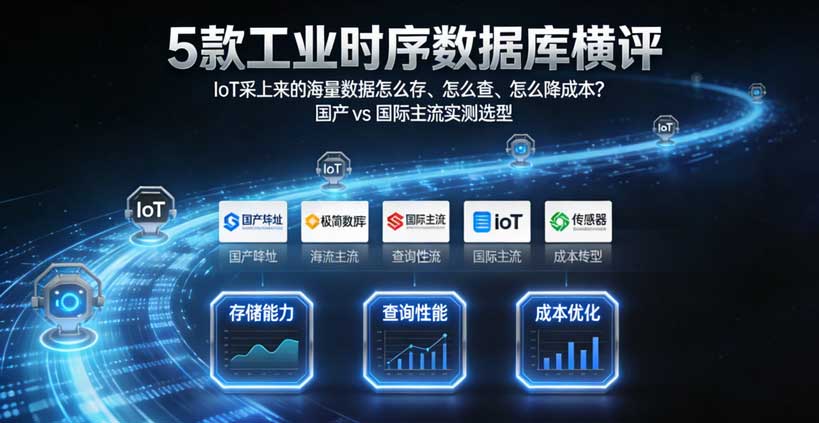
5 款产品逐一拆解
1 涛思数据 TDengine
国产开源领跑 · IoT 首选
墨天轮流行度榜首,GitHub 24,000+ stars,全球运行实例超 100 万。客户覆盖西门子、特斯拉、CATL、中石油昆仑数智、明阳智能。
TDengine 的核心哲学是"一个设备一张表"——把每台设备作为一个超级表下的子表,用标签描述设备属性,天然契合工业"设备-测点"的数据模型。它的压缩比实测达 10:1(昆仑数智中石油案例),写入速度是 InfluxDB 的 2.5 倍。2026 年 3 月,TDengine 把口号从"高性能时序数据库"升级为"AI 时代工业数据底座",同步推出 IDMP(工业数据管理平台),对标 AVEVA PI System 的 AF(Asset Framework)能力——数据目录、数据标准化、数据语境化,并暴露 MCP 接口让 AI Agent 直接调用。
开源协议
AGPL-3.0(核心),企业版商业授权
SQL 兼容
类 SQL,学习曲线低
边缘能力
内置边云同步、数据订阅
AI 集成
内置 TDgpt 组件,一条 SQL 调用时序预测/异常检测
最适合
中大规模 IoT、工业监控、能源电力、油气等重工业场景
2 清华 · 工业互联网 Apache IoTDB
云边一体 · 顶级基金会顶级项目
Apache 软件基金会顶级项目,由清华大学与工业互联网产业生态联合推动,国内多个央企、大型制造企业采用。
IoTDB 的差异化是"云边端"一体化架构:边缘节点可以独立运行、本地缓存与聚合,网络恢复后自动与云端同步;同时原生支持树形设备建模(对齐工业现场"设备-子系统-产线"的层级结构),对接 OPC-UA、MQTT 等工业协议开箱即用。它在国家智能制造、车联网、电力、钢铁等重资产行业有广泛落地。对于集团级、跨地域、边缘节点多的项目,IoTDB 的云边协同是独一档的能力。
开源协议
Apache 2.0
建模方式
树形设备建模(TimeSeries Schema)
边缘能力
原生云-边-端三层同步,边缘可独立运行
工业协议
原生 OPC-UA / MQTT 接入
最适合
央企/大型制造集团、车联网、电力、跨区域边云协同
3 DolphinDB
金融量化起家 · 超大规模 IoT 实测第一
国内金融量化交易领域事实标准之一,近年来向 IoT 场景扩张。2026 年 6 月 TSBS 基准测试中,DolphinDB 在 1000 万设备规模下写入速度是 InfluxDB 的 17 倍、TimescaleDB 的 2 倍。
DolphinDB 的核心竞争力是"数据库 + 分布式计算 + 脚本语言"三合一——不仅能存,还能直接在数据库内部跑复杂的时序分析与向量化运算,省去大量数据搬运。它的 LSM-Tree 引擎在高并发写入与压缩比上都领先,单集群可撑千万级设备、PB 级数据。对于既有海量设备、又要做高频历史回测(例如量化金融、大型制造产线、车联网轨迹分析)的项目,DolphinDB 的性能边际优势非常明显。
开源协议
社区版免费,企业版商业授权
计算能力
内置向量化脚本,数据库内直接跑分析
最大规模验证
TSBS 基准 10M 设备,写入 40.9 万行/秒
最适合
超大规模 IoT、量化金融、大型产线历史回测
4 InfluxDB
国际标杆 · 开源 TSDB 事实标准
全球时序数据库赛道最早的开拓者之一,GitHub 社区长期领跑,Flux 查询语言是时序分析的"方言标准"之一。企业版(InfluxDB Cloud / Enterprise)被欧美大量 SaaS 企业采用。
InfluxDB 的生态成熟度最高——Grafana、Telegraf、Chronograf 构成的 TIG/TICK 栈,是工业监控领域的事实标准组合。它的开源版免费但缺乏集群能力,企业版成本较高。在超大规模场景下,InfluxDB 的写入性能与查询延迟会明显落后于 TDengine 与 DolphinDB。适合团队已有 TIG 技术栈、规模中等、希望生态兼容最好的项目。
开源协议
MIT(OSS 版)
生态
TIG / TICK 栈,Grafana 原生最佳伙伴
短板
OSS 版无集群;超大规模场景性能差距明显
最适合
已有 Grafana 栈、中等规模监控、欧美企业合规需求
5 KaiwuDB
开源新锐 · 快速崛起
墨天轮时序数据库流行度第二(134.47),主打完整开源 + 活跃社区,近两年增速明显。
KaiwuDB 走的是"完整开源核心代码 + 活跃的开发者社区 + 定期技术沙龙"路线,通过开源策略快速积累用户反馈,加速产品迭代。对于中小规模项目、希望深度定制、或不想被供应商绑定的团队,KaiwuDB 是一个值得评估的开源新选项。
开源协议
完整开源
定位
新兴开源 TSDB,社区驱动
最适合
中小规模 IoT、希望深度定制、不想被绑定
核心参数对比
| 维度 | TDengine | Apache IoTDB | DolphinDB | InfluxDB | KaiwuDB |
|---|---|---|---|---|---|
| 开源协议 | AGPL-3.0 | Apache 2.0 | 社区+商业 | MIT(oss) | 完整开源 |
| 写入吞吐 | ★★★★★ | ★★★★☆ | ★★★★★ | ★★★☆☆ | ★★★★☆ |
| 压缩比 | 10:1 | 高 | 业界领先 | 中等 | 高 |
| 查询性能 | ★★★★★ | ★★★★☆ | ★★★★★ | ★★★☆☆ | ★★★★☆ |
| 边云协同 | ★★★★★ | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★★☆☆ |
| AI 原生 | ★★★★★(TDgpt+MCP) | ★★★★☆ | ★★★★★ | ★★★☆☆ | ★★★☆☆ |
| 建模方式 | 超级表+标签 | 树形设备 | 表+分区 | Measurement+Tag | 类 SQL 表 |
| 工业协议 | taosX 零代码 OPC/MQTT | 原生 OPC-UA/MQTT | 多协议 | Telegraf 插件 | 标准接口 |
| 最适合 | 中大规模 IoT / 重工业 | 央企/集团级跨域 | 超大规模+分析一体 | 中等规模+Grafana 栈 | 中小规模开源定制 |
怎么选:按场景对号入座
中大规模 IoT,追求性能与成本最优 —— 选 TDengine。"一设备一表"建模与 10:1 压缩直接省钱,AI 时代数据底座定位 + MCP 接口让它面向未来。
集团级、跨地域、边缘节点多、有 OPC-UA 需求 —— 选 Apache IoTDB。云-边-端三层原生同步是它的独占能力。
超大规模(千万级设备、PB 级数据)+ 复杂历史分析/回测 —— 选 DolphinDB。TSBS 实测写入与查询性能在最大规模下边际优势最大。
已有 TIG/Grafana 技术栈、中等规模 —— 选 InfluxDB。生态最兼容,团队零学习成本。
中小规模、希望深度定制、不想被供应商绑定 —— 选 KaiwuDB。完整开源,社区活跃。
还有一条简单的判断逻辑:看数据规模,也看"数据要干什么"。只是存与展示,TDengine 与 InfluxDB 都能搞定;要边云协同选 IoTDB;要存+算一体选 DolphinDB;要面向 AI Agent 选 TDengine(IDMP + MCP)。
避坑清单
不要拿通用数据库干时序的活。MySQL/PG 在时序场景下的写入、压缩、聚合性能都远不如专用 TSDB,长期成本会爆。
压缩比不是广告数,要看你的真实数据特征。设备数、测点频率、数据分布、乱序程度都会影响,POC 阶段一定要用真实样本跑。
建模方式决定后期扩展难度。"一个设备一张表"适合设备结构稳定的场景;树形建模适合层级复杂的集团;表+分区适合高频变动标签。先想清楚建模,再选产品。
集群与高可用不是免费午餐。InfluxDB OSS 版没集群能力,要上集群得上企业版;其他开源版集群能力也需自行运维。要评估团队运维能力再下决定。
别忘了数据接入层。时序数据库只是底座,真正的工程量在 OPC→MQTT→TSDB 的数据接入与转换。TDengine 的 taosX 与 IoTDB 的原生 OPC-UA 支持能省很多实施成本。