2026 “极限制造”白皮书:突破“最后一微米”生死线!为何 40% 的半导体与高端 3C 装备厂强拆传统总线,全面拥抱“亚纳秒级”时空同步架构?
2026-09-26 14:29:00
#CEO#研发副总#系统架构师
序章:最后一微米——工业世界的"物理高墙"
2025年秋天,长三角某半导体设备厂的厂房里,一台价值2亿的进口光刻机正在调试。这台机器占据了整间千级洁净室的核心位置,周围环绕着价值数千万的辅助设备。工程师团队已经连续工作了72小时,所有人都在等一个数字——套刻精度。
92nm。
不是90nm。距离产线要求的90nm套刻精度,只差那么一点点。但就是这"一点点",让价值2亿的设备无法通过验收。更让人绝望的是,团队已经换了最贵的直线电机,用了最重的大理石底座,装了最好的气浮导轨。机械精度已经到顶了。
问题出在哪里?
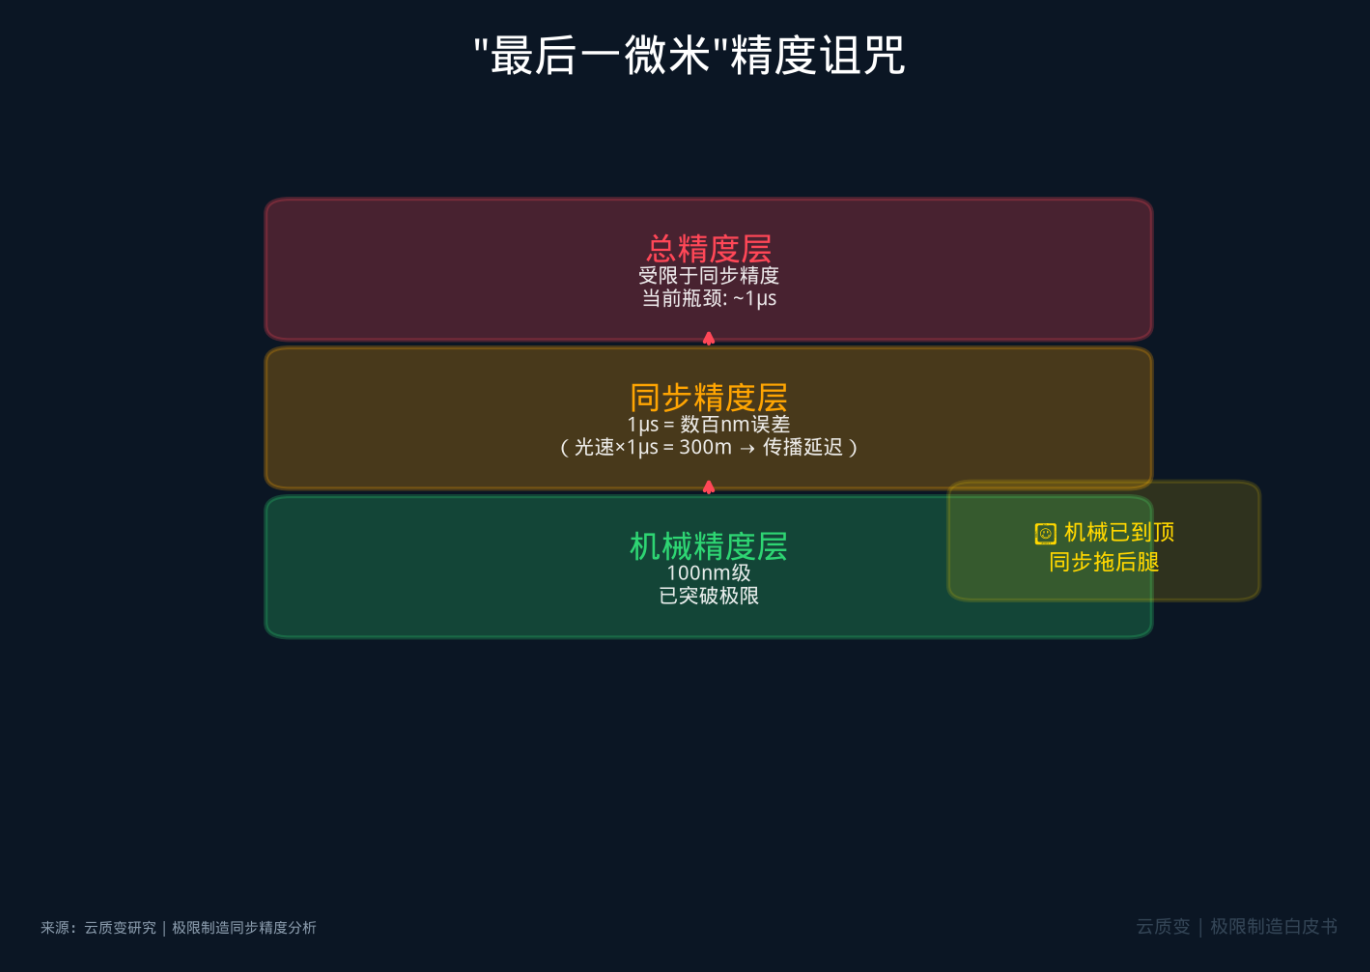
答案藏在一个几乎没人关注的地方——控制系统的时间同步精度。当运动轴的移动速度达到10m/s时,控制系统每1微秒(μs)的同步抖动,就会转化为10纳米的位置偏差。而传统EtherCAT总线的同步抖动,恰恰就在1μs量级。数十个轴的累积抖动叠加起来,轻松吞掉了那宝贵的10nm精度余量。
这不是个案。在长三角的半导体设备圈、Micro-LED巨量转移设备圈、飞秒激光加工圈,类似的"精度诅咒"正在上演。工程师们把机械做到了极致,却发现控制系统的时间同步精度拖了后腿。就像造了一辆完美的F1赛车,却给它装了一个民用的GPS导航——精度不够赢。
据不完全统计,仅长三角地区就有超过200家企业在从事半导体设备、面板设备或精密激光加工设备的研发与制造。其中,至少40%的企业在设备调试过程中遇到过"机械精度已达标、但系统总精度不达标"的困境。这些企业投入了大量的时间和资金去解决"精度问题",但大多数都走错了方向——它们不断地升级机械硬件,却忽视了真正的问题根源。
这堵墙,我们叫它"最后一微米"。
不是字面上的一微米,而是一个隐喻:当你把所有能做的都做到极致之后,那个看似微不足道的、藏在时序同步里的"最后一微米",决定了你是成功还是失败。
打破这堵墙的方法,不是买更贵的电机,不是换更硬的底座,而是彻底重构控制系统的"时间观"——从毫秒级跃迁到亚纳秒级。
欢迎来到"极限制造"的世界。
第1章:什么是"极限制造"?——当精度成为生死线
1.1 定义:不是"更精密",而是"质变"
极限制造(Extreme Manufacturing),是指尺寸公差小于10纳米、表面质量趋近原子级平整度的制造范式。它不是传统精密制造的"升级版",而是一个全新的物理维度。
打个比方:传统精密制造像是在高速公路上开车,精度到毫米级就够了;极限制造像是在纳米尺度的钢丝上跳舞,每一个动作都必须精确到原子级别。
在这个尺度上,物理规律本身开始"捣乱"。热膨胀、振动、电磁干扰、甚至空气分子的热运动,都会成为精度的敌人。而其中最隐蔽、最致命的敌人,是时间同步误差。
为什么说是"质变"而非"量变"?因为在纳米尺度下,传统的误差分析方法不再适用。在微米级场景中,各种误差源可以近似看作线性叠加,用均方根(RSS)方法就能估算总误差。但在纳米级场景中,误差源之间存在复杂的非线性耦合——温度变化不仅导致机械形变,还改变了材料的弹性模量;振动不仅产生位置偏移,还通过压电效应干扰传感器信号。这种非线性耦合意味着:你不能简单地把各个误差源"加起来",因为它们会相互"放大"。
1.2 三大应用场景
场景一:半导体前道设备
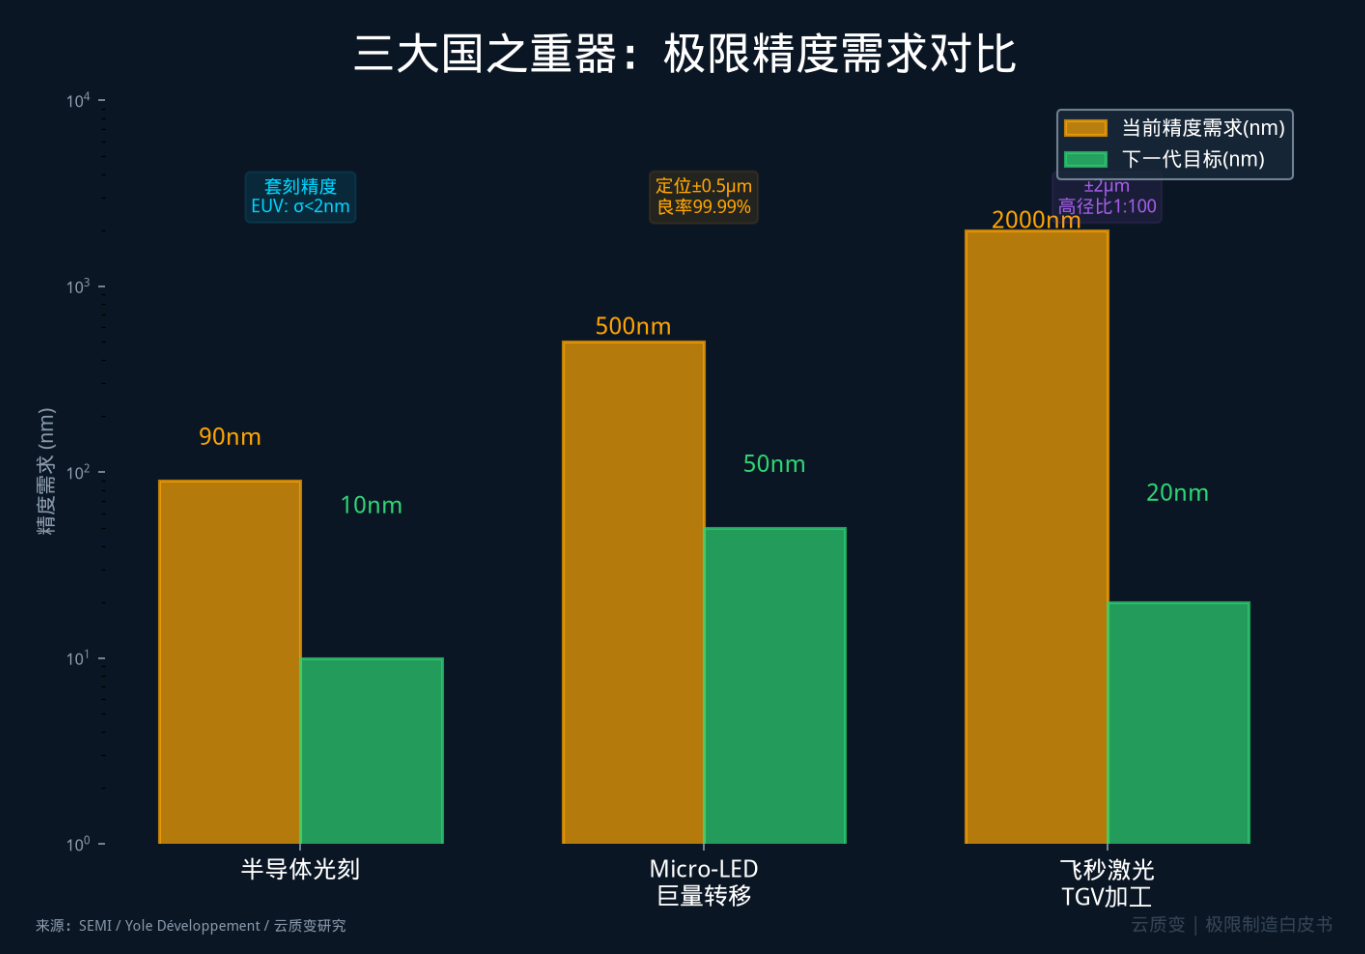
这是极限制造的"皇冠明珠"。光刻机的套刻精度、刻蚀机的线宽控制、薄膜沉积的均匀性,每一项都要求在纳米尺度上做到极致。2025年,国产纳米压印光刻已经突破10nm线宽(璞璘科技PL-SR系列),长鑫存储G5平台实现了11.95nm有源区半间距。这些数字的背后,是对控制系统同步精度的疯狂要求。
半导体前道设备的精度挑战在于"多重叠加":晶圆台需要在大行程(300mm)范围内实现纳米级定位,同时还要承受高速运动带来的振动和热效应。光刻过程中的每次曝光都需要在极短时间内完成对准、曝光、偏移三步,而这三步之间的时间同步精度直接决定了最终图案的质量。
场景二:Micro-LED巨量转移
把数百万颗微米级的LED芯片,一颗一颗地"抓取"并"放置"到基板上,精度要求≤±0.5μm,良率要求≥99.99%。注意,这不是实验室指标,是量产指标。百万级像素的屏幕上,0.01%的缺陷率就意味着数千个死像素——这对消费者体验是致命的。
巨量转移的难度在于"规模×精度×速度"的三重约束。你不能为了精度牺牲速度(否则产率不达标),也不能为了速度牺牲精度(否则良率不达标)。这个"不可能三角"的突破口,恰恰在于时间同步精度的提升——更精确的时序控制,可以让运动系统在更高的速度下仍然保持精确的位置跟随。
场景三:飞秒激光加工
飞秒激光的脉冲宽度只有10⁻¹⁵秒(千万亿分之一秒)。在这个时间尺度上加工材料,热影响区可以控制在10nm以内。但如果激光脉冲和运动控制之间的同步误差超过几纳秒,整个加工精度就会崩塌。
飞秒激光加工的独特之处在于:它同时对"时间精度"和"空间精度"都有极高要求。脉冲宽度决定了加工的"时间精度"(越短越好),而脉冲与运动的同步精度决定了"空间精度"(越准越好)。两者缺一不可。
1.3 极限制造与传统精密制造的本质差异
理解极限制造,需要理解它与传统精密制造之间的"质变边界"。
在传统精密制造中,误差的来源是相对独立和可预测的。机械误差、热误差、力误差各自独立存在,可以用统计学方法进行建模和补偿。总误差可以近似看作各误差源的均方根(RSS)叠加。
但在极限制造中,误差源之间出现了强烈的非线性耦合。举一个具体的例子:当运动轴以10m/s的速度移动时,摩擦产生的热量会导致导轨局部温度升高;温度升高改变了导轨的材料弹性模量;弹性模量的变化又影响了导轨的直线度;直线度的变化反过来改变了摩擦力分布……这是一个闭环的耦合系统,不能用简单的线性叠加来描述。
这种非线性耦合的直接后果是:传统的"测量→建模→补偿"方法不再有效。因为你无法准确地"测量"一个不断变化的耦合系统的误差。这正是为什么极限制造需要从"事后补偿"转向"源头控制"——而时间同步精度的提升,就是最根本的"源头控制"手段之一。
1.4 市场数据:一个正在爆发的千亿赛道
超精密加工中心全球市场规模在2025年达到15.3亿美元,预计到2031年增长至24.8亿美元,年复合增长率8.36%。亚太地区以39.55%的市场份额成为增长最快的区域。半导体和电子终端应用占据了31%的市场份额,且以11.3%的CAGR领跑所有细分领域。
5轴超精密加工中心以39.45%的市场份额和10%的CAGR成为设备类型中增长最快的品类——这反映了复杂曲面精密加工需求的爆发。
这不再是"实验室里的游戏",而是真金白银的产业竞赛。每一个百分点的精度提升,背后都是数十亿的市场价值。
值得特别关注的是,5轴超精密加工中心以39.45%的市场份额和10%的CAGR成为设备类型中增长最快的品类。这反映了复杂曲面精密加工需求的爆发——半导体设备的核心零部件(如光刻机的反射镜、刻蚀机的电极板)大量使用复杂曲面的超精密加工。
超精密加工中心全球市场规模(2025-2031),面积图+增长率叠加,深蓝品牌色系,标注关键拐点年份
第2章:精度诅咒——为什么"更贵的电机"解决不了问题
2.1 传统思路的尽头
面对精度问题,大多数工程师的第一反应是:换更贵的执行器。直线电机、大理石底座、气浮导轨、零间隙轴承……这些"硬件堆料"的思路在过去二十年里确实有效,但现在已经撞到了天花板。
一组数据可以说明问题:
顶级直线电机的定位精度:±50nm
大理石底座的热稳定性:±20nm/℃
气浮导轨的直线度:±100nm/m
高精度光栅尺的分辨率:±1nm
这些指标看起来已经很优秀了。但当你的目标精度是10nm级别时,这些"优秀"的硬件反而成了瓶颈。更关键的是,这些硬件的精度提升已经进入了"边际收益递减"的阶段——从100nm提升到50nm,成本可能翻了一倍;从50nm提升到10nm,成本可能要翻十倍。
这就是精密工程领域的"收益天花板":花再多的钱,机械精度也就这样了。
2.2 真正的凶手:控制系统的同步抖动
问题不在"力量",而在"时间"。
在高速多轴运动中,每个轴的运动控制指令需要在同一时刻发出。如果轴A和轴B的控制指令之间有时间差,哪怕只有1微秒,在10m/s的运动速度下,就会产生10纳米的位置偏差。数十个轴的累积偏差叠加,轻松突破100nm。
让我们做一个更具体的计算。假设一个半导体设备有20个运动轴,每个轴的运动速度为5m/s,使用EtherCAT总线控制(同步抖动约1μs)。那么:
单个轴的同步位置偏差:5m/s × 1μs = 5nm
20个轴的累积偏差(RSS):5nm × √20 ≈ 22nm
worst case累积偏差:5nm × 20 = 100nm
如果你的系统精度要求是50nm,那么光同步抖动就已经占了22-100nm——要么勉强达标,要么直接超标。
传统工业总线的同步抖动是多少?
| 总线类型 | 同步抖动 | 对应位置偏差(@10m/s) | 20轴累积偏差(RSS) |
|---|---|---|---|
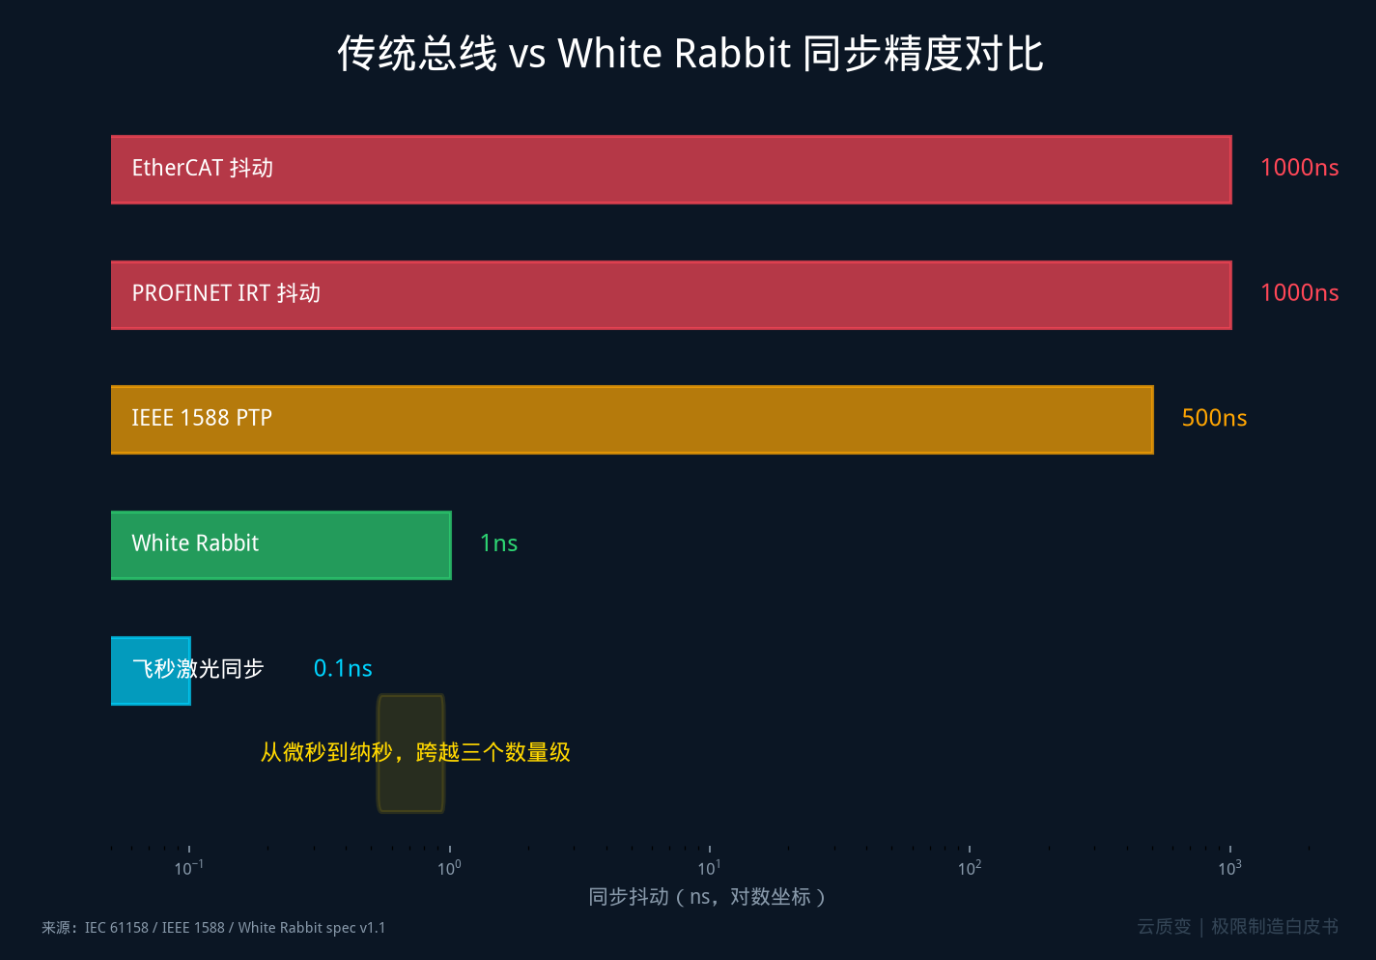
| EtherCAT | ~1μs | ~10nm/轴 | ~45nm |
| PROFINET IRT | ~1μs | ~10nm/轴 | ~45nm |
| 标准IEEE 1588 PTP | 100ns-1μs | 1-10nm/轴 | 4.5-45nm |
| White Rabbit | <1ns | <0.01nm/轴 | <0.045nm |
看到了吗?从EtherCAT到White Rabbit,20轴系统的同步偏差从45nm骤降到0.045nm——整整差了1000倍。
"最后一微米"精度诅咒示意图——机械精度 vs 同步精度 vs 总精度的堆叠柱状图,展示不同总线方案下的精度构成
2.3 木桶原理的工业版
这就是极限制造领域的"木桶原理":最短的那块板,不是机械精度,不是传感器精度,而是时间同步精度。
据行业内的非公开调查,在长三角地区的高端设备集成商中,约70%的设备精度不达标的根因,不在机械层面,而在控制系统的时序同步层面。这个比例在半导体设备领域更高,接近80%。
但很少有厂商愿意公开承认这一点。因为承认了,就意味着要推翻过去十年的控制架构设计,意味着要从PLC+EtherCAT的"舒适区"走出来,进入一个全新的技术领地。
还有一个更深层的原因:时序同步问题太"隐蔽"了。机械精度可以用激光干涉仪直接测量,传感器精度可以用标准件校准,但时序同步的抖动需要用专门的高精度时间间隔分析仪才能捕捉——大多数工厂根本没有这个设备。所以很多精度问题被错误地归因于"机械不好"或"传感器不准",然后花大价钱换了硬件,问题依然存在。
2.4 一个真实的案例
2025年上半年,某国产Micro-LED巨量转移设备商在调试其新一代设备时遇到了良率瓶颈。设备的机械定位精度已经做到了±0.3μm,但实际转移良率始终在99.5%左右徘徊,达不到99.9%的量产要求。
团队花了两个月时间排查,换了更精密的导轨、更高精度的编码器、甚至重新设计了运动平台。良率提升到了99.6%,然后就到了天花板。
最终的突破口来自一位从CERN回国的工程师。他用时间间隔分析仪测量了控制系统的同步抖动,发现EtherCAT主站与各从站之间的实际同步抖动在800ns-1.2μs之间波动——比标称的1μs要好一些,但对于±0.5μm的转移精度来说,这个抖动仍然太大了。
解决方案是将关键的运动控制轴从EtherCAT切换到基于FPGA的White Rabbit同步架构。切换后,同步抖动降到了500ps以下,转移良率在两周内从99.6%提升到了99.92%。
这个案例完美诠释了"精度诅咒"的本质:不是机械不够好,是时间不够准。
第3章:从CERN到车间——White Rabbit协议的工业觉醒
3.1 大型强子对撞机的"时间焦虑"
要理解White Rabbit的来历,我们得先去看看人类历史上最精密的"计时工程"——欧洲核子研究中心(CERN)的大型强子对撞机(LHC)。
LHC是一个周长27公里的环形加速器,数千个磁铁、探测器、射频腔分布在环形的不同位置。当两束质子在接近光速的状态下对撞时,分布在环上的数千个探测器必须在"同一时刻"记录数据。这个"同一时刻"的精度要求是多少?亚纳秒级。
为什么?因为粒子对撞产生的次级粒子寿命极短(皮秒到纳秒量级),如果不同探测器之间的时间同步有偏差,就无法重建粒子的轨迹和能量。简单来说:时间不同步,实验就废了。
更具体地说,LHC的每次对撞会产生数百个次级粒子,这些粒子以不同速度飞向周围的各种探测器。物理学家需要精确知道每个粒子到达每个探测器的时间,才能反推出粒子的质量、电荷和运动方向。如果探测器之间的时间同步偏差超过1纳秒,重建出来的粒子轨迹就会出现严重错误——相当于在黑暗中画了一幅完全走样的地图。
3.2 White Rabbit的诞生
2008年,CERN启动了White Rabbit项目,目标是开发一套能在10公里范围内实现亚纳秒级时间同步的网络协议。这个名字来源于刘易斯·卡罗尔的《爱丽丝梦游仙境》——白兔总是迟到,而CERN的工程师们决定让时间"不再迟到"。
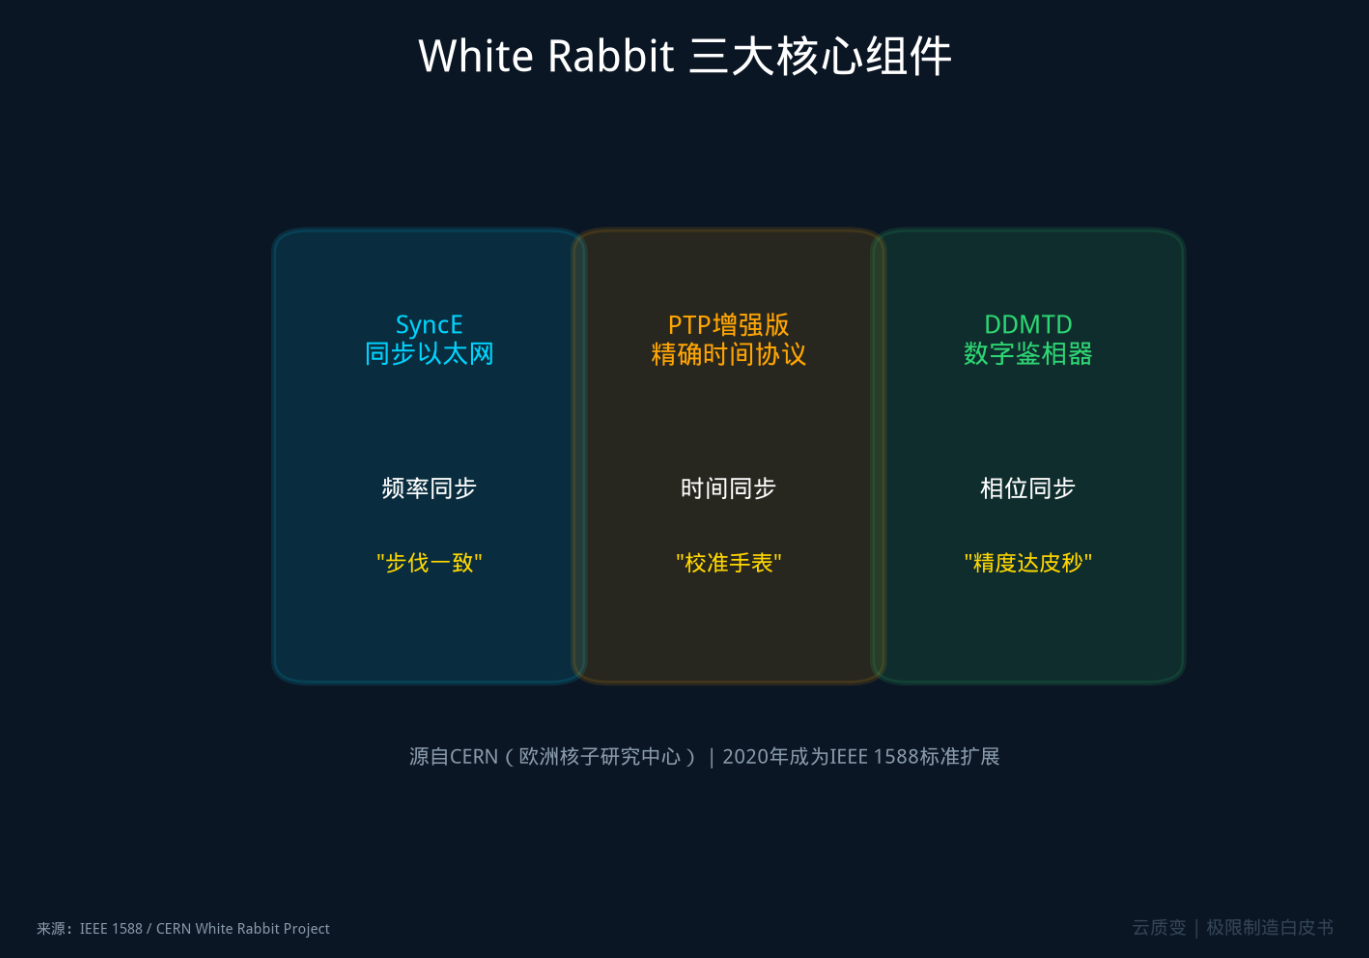
这个项目融合了三项关键技术:
第一项:同步以太网(SyncE)——频率同步
普通的以太网传输数据时,发送端和接收端的时钟是独立的,存在频率偏差。SyncE的做法是:让网络设备(交换机、终端)的时钟都锁定到同一个参考时钟上,实现频率层面的同步。
技术细节:SyncE利用了以太网物理层(PHY)的时钟恢复机制。每台WR交换机的PHY芯片从接收到的以太网信号中提取时钟频率,然后通过锁相环(PLL)将这个频率锁定到上游参考时钟。经过级联的多台交换机,所有设备的物理层时钟频率都被"驯服"到同一个参考上。
这就好比让所有乐手都听同一个节拍器——大家的"拍子"是一样的。
第二项:精密时间协议(PTP增强版)——时间同步
IEEE 1588定义的PTP(Precision Time Protocol)本身就能实现百纳秒级的时间同步。它的工作方式是:主站周期性地向从站发送"时间同步包",从站通过计算数据包的传输延迟来校准自己的本地时钟。
White Rabbit在PTP的基础上做了大量增强:更精确的硬件时间戳(在PHY边界打时间戳,而非软件层)、更完善的路径延迟补偿(通过DDMTD测量光纤的不对称延迟)、更严格的协议一致性要求。
如果说SyncE让所有乐手的"拍子"一样,那么PTP增强版就是让所有乐手的"起始时间"一样——大家在同一秒的同一毫秒开始演奏。
第三项:数字双混频鉴相器(DDMTD)——相位同步
这是White Rabbit的"杀手锏",也是最让工程师们惊叹的技术创新。
DDMTD是一种相位测量技术,原本用于射电天文和粒子物理领域。它的核心思想极其巧妙:对两个时钟信号的相位差进行"放大测量"。
具体原理如下:假设有两个1GHz的时钟信号A和B,它们之间存在1皮秒的相位差。直接测量这1皮秒的相位差几乎不可能——因为1GHz时钟的周期是1纳秒,1皮秒只占周期的千分之一,普通数字逻辑根本无法分辨。
DDMTD的做法是:将信号A与一个频率略有不同的参考信号f1混频,将信号B与另一个频率略有不同的参考信号f2混频。混频后的信号频率被"降频"到了kHz级别,但原始的相位差被"放大"了数十万倍。原来1皮秒的相位差,在降频信号中变成了100纳秒甚至更大——这就完全可以用普通的数字逻辑精确测量了。
通过这种方式,DDMTD实现了皮秒级的相位分辨率,这是White Rabbit能够达到亚纳秒同步精度的关键技术。
这三项技术组合在一起,让White Rabbit实现了<1ns的同步精度,在90公里的光纤链路上达到了64.5皮秒的标准差。
White Rabbit技术三大核心组件拆解——SyncE + PTP + DDMTD的原理与协作关系,层次化架构图
3.3 从粒子物理到工业现场
2020年,White Rabbit正式被纳入IEEE 1588-2019标准的Annex M,从CERN的"内部工具"升级为国际标准。这意味着任何企业都可以基于这个标准开发工业级的亚纳秒同步产品。
一个标志性的事件是:2026年7月16日,印度在CSIR-NPL(国家物理实验室)和ISRO(印度空间研究组织)的联合推动下,正式启用了基于White Rabbit技术的国家级时间分发网络。这个网络覆盖了印度全境的主要科研机构和航天设施,实现了皮秒级的时间同步精度。这不仅是印度科技基础设施的里程碑,更标志着White Rabbit技术从实验室走向国家级关键基础设施的成熟度。
从粒子物理到工业现场的技术迁移,并非一帆风顺。CERN的环境是高度受控的实验室环境——恒温、恒湿、无振动、无电磁干扰。而工业现场充满了电磁干扰(变频器、伺服驱动器、焊接设备产生的EMI)、温度波动(车间昼夜温差可达10-15℃)、振动(冲压机、压缩机产生的地面振动)和粉尘(即使是洁净室,也有ISO等级对应的颗粒度限制)。
将WR的亚纳秒精度"搬"到嘈杂的工厂车间,需要在以下几个维度做大量的工程化工作:
电磁兼容(EMC):WR设备的FPGA板和光模块需要严格的电磁屏蔽设计,避免工业现场的EMI干扰时间戳电路
温度补偿:需要实时监测FPGA芯片温度和光纤温度,并通过算法补偿温度引起的时间漂移
振动隔离:WR设备本身(特别是Grandmaster Clock)需要安装在振动隔离平台上
光纤保护:工业现场的光纤需要穿金属管保护,避免机械损伤和温度波动
这些工程化挑战,也是为什么从2020年标准化到2026年才出现首批规模化工业部署——中间这6年,主要就是在解决这些"从实验室到车间"的工程问题。
第4章:亚纳秒级时空同步架构——技术全拆解
4.1 "时间就是位置"
在极限制造的世界里,有一条铁律:时间误差 = 位置误差。
公式很简单:Δx = v × Δt
其中Δx是位置误差,v是运动速度,Δt是时间同步误差。
当运动速度v = 10m/s时:
Δt = 1μs → Δx = 10nm
Δt = 100ns → Δx = 1nm
Δt = 1ns → Δx = 0.01nm
Δt = 100ps → Δx = 0.001nm
当运动速度更高时(比如50m/s的激光扫描系统),同样的时间误差会被进一步放大:
Δt = 1μs → Δx = 50nm
Δt = 1ns → Δx = 0.05nm
看到差距了吗?从微秒到纳秒,位置精度提升了1000倍。这就是为什么亚纳秒同步对极限制造如此关键。
对于CEO和非技术背景的管理者,这里有一个直观的理解方式:想象你在高速公路上以100km/h的速度行驶(约28m/s)。如果你的GPS定位有1微秒的时间误差,你的位置误差就是28微米——在普通导航中完全可以忽略。但如果你是在用激光切割以100km/h移动的材料,28微米的时间误差可能就意味着切割线偏移了28微米——这在半导体和Micro-LED领域就是"合格"与"报废"的区别。
4.2 架构全景
一个完整的亚纳秒级时空同步架构由三个核心层级组成:
第一层:时间源(Grandmaster Clock)
整个系统的"时间心脏"。通常由铷原子钟或铯原子钟提供频率基准,结合GPS/北斗卫星授时提供UTC时间参考。时间源的长期稳定度决定了整个系统的"天花板"。
典型的配置是:铷原子钟(短期稳定度10⁻¹¹/秒)+ GPS驯服(长期稳定度10⁻¹²/天)+ White Rabbit协议分发。铷原子钟的特点是短期稳定度极好(秒级时间尺度上几乎不漂移),但长期稳定度有限(每天可能有微秒级的漂移)。GPS授时恰好相反——短期稳定度一般,但长期稳定度极好(因为GPS卫星上搭载的是铯原子钟,精度极高)。两者"互补",组合在一起就能同时获得优秀的短期和长期稳定度。
第二层:时间分发网络(WR Switch Network)
White Rabbit交换机负责将精确的时间信号分发到网络中的每一个节点。每一台WR交换机都要做两件事:
频率同步:通过SyncE锁定到上游参考时钟
时间同步:通过PTP协议计算并补偿链路延迟
关键指标是"附加抖动"——每台WR交换机引入的时间抖动应<100ps。在一个10节点的链路上,总累积抖动<1ns。
WR交换机的核心是一个FPGA,它实现了WR协议的所有时间敏感逻辑。普通的数据转发可以通过硬件MAC(媒体访问控制)层完成,但时间戳的打标、DDMTD的相位测量、PTP协议的状态机运算——这些都必须在FPGA内部完成,以确保确定性延迟。
第三层:时间终端(WR Endpoint/Node)
每台WR终端设备必须包含一个FPGA,实现White Rabbit PTP Core(WRPC)的核心逻辑。FPGA在以太网PHY(物理层)的边界直接对数据包打时间戳,消除操作系统和软件栈引入的不确定性。
WR终端的设计是一个"异构架构":FPGA负责时间同步和实时控制(纳秒级确定性),而ARM处理器或x86处理器负责上层应用和非实时任务(如人机界面、数据记录、网络通信等)。两者通过高速总线(如AXI总线)通信。
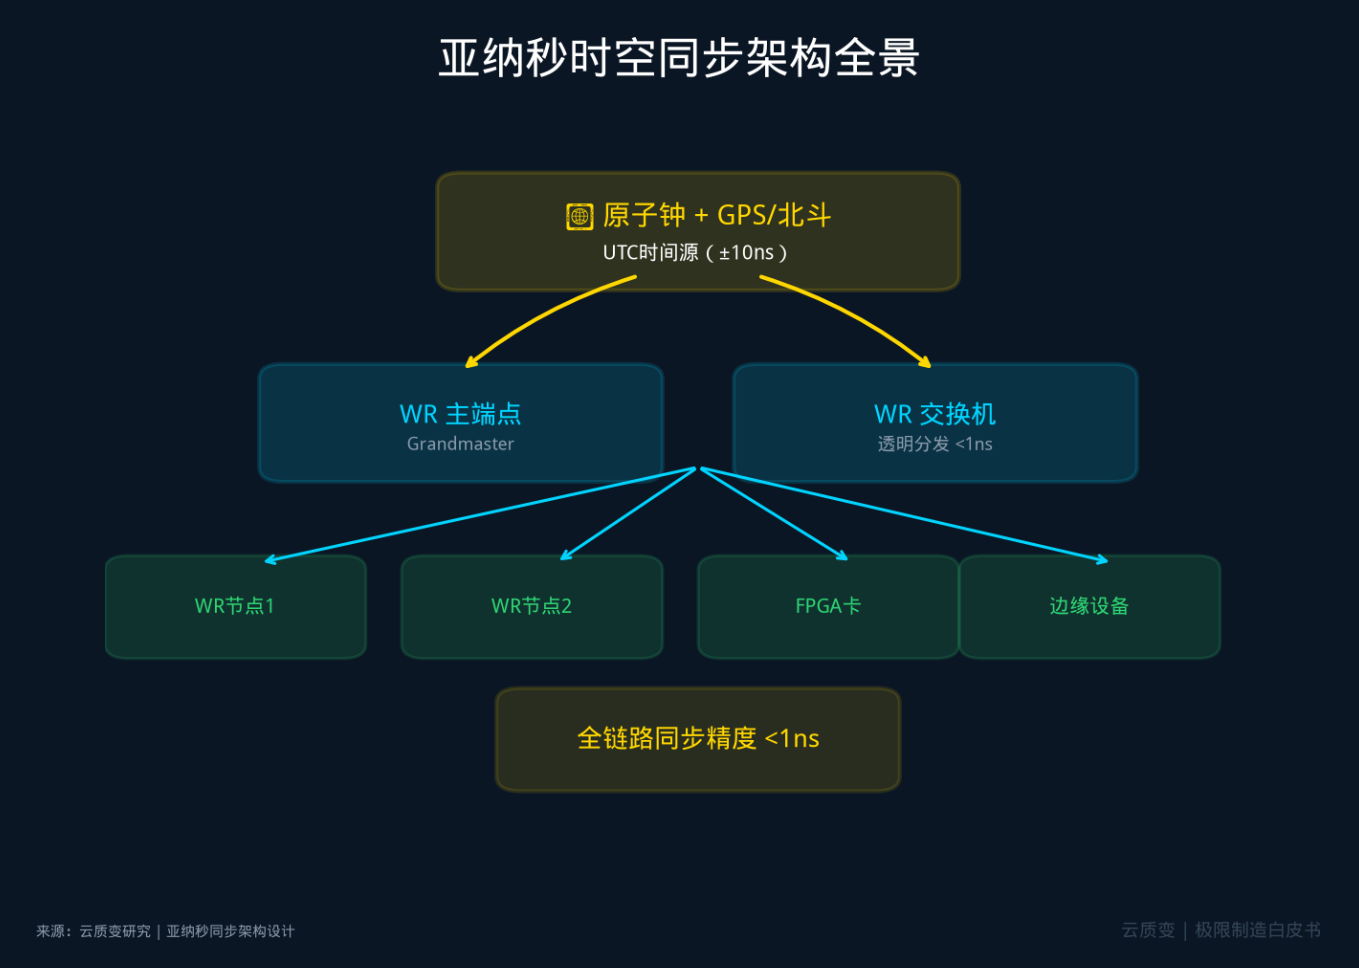
亚纳秒级时空同步架构全景图——从原子钟到FPGA终端的三层架构,含数据流与时序标注
4.3 FPGA的核心角色:为什么必须用它?
这是很多CEO和VP of R&D最难理解的部分:为什么传统的PLC不行,非得用FPGA?
答案在于三个关键词:
硬件时间戳
FPGA可以在以太网PHY芯片接收数据包的瞬间,直接在硬件层面打上时间戳。这个时间戳的精度可以达到皮秒级。而PLC或工控机(IPC)需要通过操作系统内核、网络驱动、协议栈……等软件层面处理,每一步都会引入不可预测的延迟(即"抖动")。
具体来说,当一个Ethernet帧到达IPC的网卡时,它需要经历以下处理链路:网卡中断→操作系统内核协议栈→驱动程序→用户态应用。每个环节的延迟都受操作系统调度影响,可能在几微秒到几百微秒之间波动。而FPGA直接在硬件层面处理,延迟是固定的、可预测的——通常在几个时钟周期内(几十纳秒)。
确定性延迟
FPGA的逻辑是"硬连线"的——同样的输入,每次都会产生完全相同的输出,延迟是确定性的。而PLC和IPC的延迟是概率性的——大多数时候可能只有几微秒,但偶尔会因为操作系统调度、中断处理等原因飙升到几十甚至几百微秒。
在极限制造中,"偶尔的异常"比"持续的偏差"更危险。因为持续的偏差可以通过校准来补偿,但偶尔的异常偏差无法预测、无法补偿——它就是那个让良率突然下降的"隐形杀手"。
相位测量
DDMTD这种皮秒级的相位测量技术,必须在FPGA内部实现。它需要高速数字信号处理能力,以及对时钟边沿的精确控制,这些都只有FPGA能做到。
DDMTD在FPGA中的实现涉及:高速混频器(将GHz信号降频到kHz)、高精度计数器(测量降频信号的相位差)、数字滤波器(消除测量噪声)。这些功能在FPGA中可以并行执行,每个时钟周期都能输出一次测量结果——这种速度和精度,是任何软件实现都无法企及的。
简单说:PLC是"软件模拟的时间管理",FPGA是"硬件实现的时间管理"。在极限制造的世界里,软件模拟的精度天花板就是微秒级,只有硬件管理才能突破到纳秒以下。
4.4 开源生态的力量
White Rabbit的一个重要特点是全开源:硬件设计、FPGA固件、软件驱动、协议栈全部开源。核心项目White Rabbit PTP Core(WRPC)提供了完整的FPGA参考设计,企业可以在此基础上进行定制化开发。
这大大降低了技术门槛。企业不需要从零开始设计WR协议栈,而是可以站在开源社区的肩膀上,专注于自己的应用层算法和控制逻辑。
WRPC开源项目的关键组件包括:
Wishbone总线架构:标准化的IP核互连总线
WR PTP核心:实现PTP协议状态机和DDMTD相位测量
Soft-PLL:数字锁相环,实现本地时钟与上游参考的同步
SDRAM控制器:用于存储时间戳和历史数据
UART/WB Conveyors:用于与主机处理器通信
企业在基于WRPC开发自己的产品时,通常需要做的定制化工作包括:添加特定的I/O接口(如编码器接口、PWM输出)、优化时钟树设计以满足特定的抖动指标、集成自己的运动控制算法等。
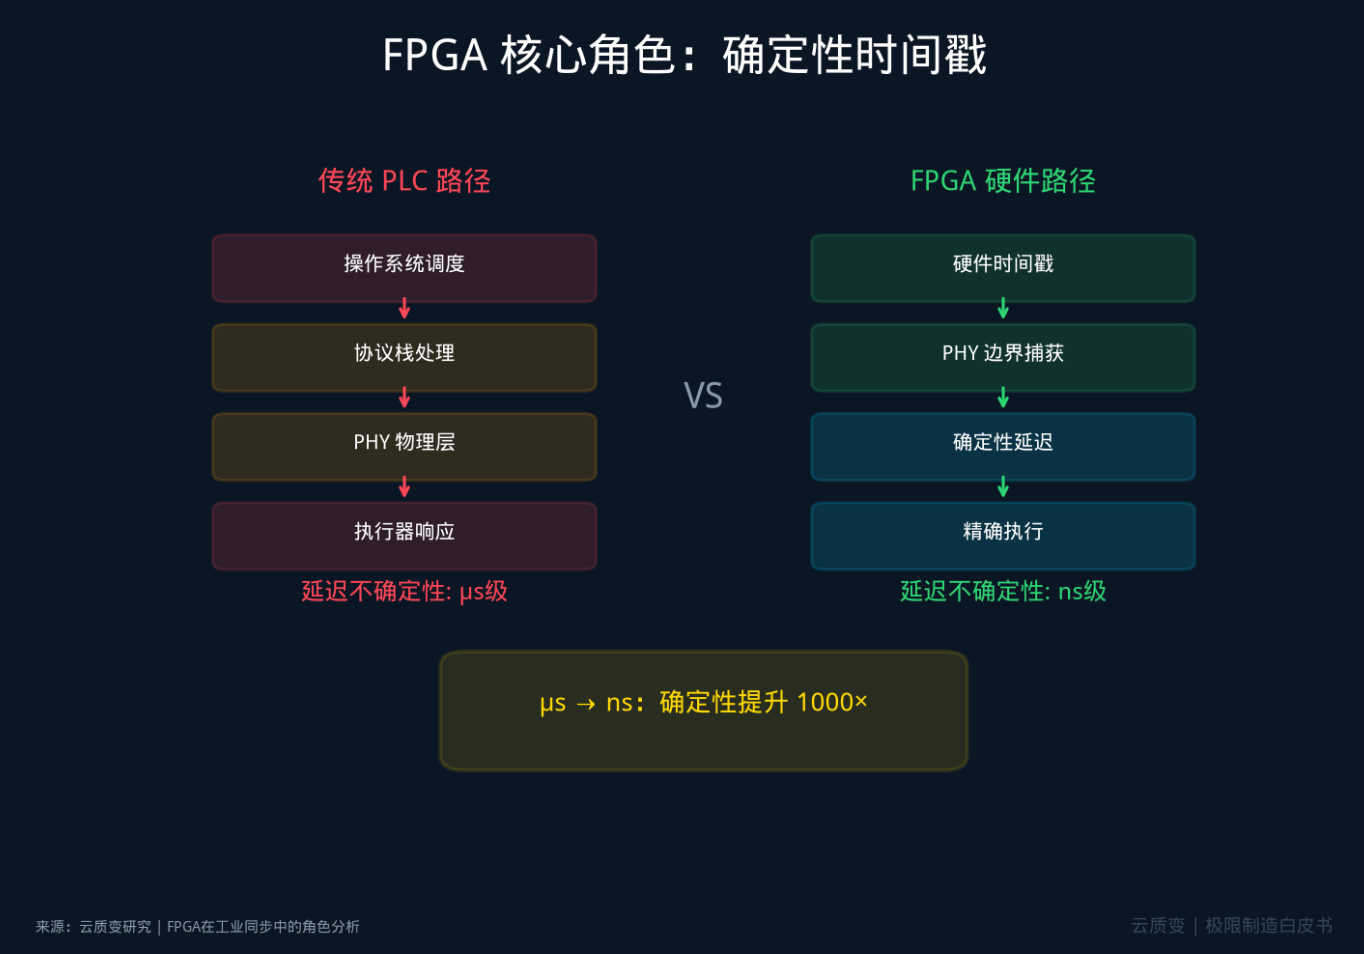
FPGA在同步架构中的核心角色——从PHY边界时间戳到DDMTD相位测量的数据流图
第5章:EtherCAT/PROFINET的"出局"——传统总线的极限
5.1 不是"不好",是"不够"
先说一句公道话:EtherCAT和PROFINET是非常优秀的工业总线。在95%以上的工业场景中,它们的性能完全够用。高速包装、物流分拣、注塑成型、CNC加工……这些场景中,微秒级的同步精度绰绰有余。
EtherCAT自2003年发布以来,已经成为全球使用最广泛的工业以太网之一。它的高效性在于"飞读飞写"(processing on the fly)机制——数据帧在经过每个从站时,从站可以在不中断帧传输的情况下读取或插入数据。这使得EtherCAT的总线利用率极高,一个周期内可以完成数百个从站的数据交换。
但极限制造不属于这95%。
5.2 传统总线的三个"死穴"
死穴一:抖动不可消除
EtherCAT的同步抖动约1μs,这不是因为设计不好,而是架构决定的。EtherCAT的分布式时钟(DC)机制虽然精巧,但本质上依赖于主站周期性地校准从站时钟。这个校准过程本身就有不确定性,加上操作系统和协议栈的软件抖动,1μs已经是它的物理极限。
具体来看EtherCAT DC的工作流程:主站在每个通信周期开始时发送一个"系统时间"广播,各从站根据接收到广播的时间来校准自己的本地时钟。但问题是:数据帧在从站之间的传递存在"处理延迟"(processing delay),这个延迟虽然在理论上可以测量和补偿,但实际上会受到温度、电压、信号完整性等因素的影响而产生微小波动。这些微小波动的累积,就是那个无法消除的1μs抖动。
死穴二:节点间相位一致性无法保证
EtherCAT能保证每个从站的时钟"频率"一致(都在1μs周期内跳动),但不能保证"相位"一致(各自在周期的哪个位置跳动)。这意味着两个从站可能在同一时刻发出相差数百纳秒的控制指令。
这在普通运动控制中不是问题——因为几百纳秒的偏差对于毫米级精度的应用来说完全可以忽略。但在纳米级精度的极限制造中,这个相位偏差就是致命的。
White Rabbit的DDMTD技术恰恰解决了这个问题:它不仅能保证频率一致,还能保证相位一致——所有WR节点之间的相位差可以被控制在亚纳秒以内。
死穴三:光纤不对称性补偿能力不足
在光纤链路中,上行和下行方向的传输延迟往往不对称(由于光器件、连接器、光纤本身的差异)。这种不对称性会导致时间同步的系统误差——即使频率和相位都对齐了,绝对时间仍然有偏差。
EtherCAT对这种不对称性的补偿能力有限,因为它的延迟测量机制精度不足。White Rabbit通过DDMTD技术可以精确测量光纤的上行/下行不对称延迟,并在PTP协议中进行补偿。这使得WR即使在数公里的光纤链路上,仍然能保持亚纳秒的同步精度。
5.3 一个恰当的类比
用EtherCAT做极限制造的控制总线,就像用GPS导航跑F1赛车。GPS的精度是3-5米,对于普通驾驶来说完全够用。但F1赛车需要的是厘米级的差分GPS,甚至是激光雷达+惯性导航的组合。
不是GPS不好,是场景变了。
同样,不是EtherCAT不好。在包装机械、物流输送、注塑成型这些场景中,EtherCAT的性价比远超White Rabbit。但当精度要求从微米级进入纳米级,当速度要求从米级进入十米级,EtherCAT的同步精度就不再够用了。
传统工业总线 vs White Rabbit同步精度对比——雷达图展示抖动、相位一致性、确定性延迟、光纤补偿、可扩展性五个维度
第6章:三大"国之重器"的精度之战
6.1 半导体前道设备:纳米级的"军备竞赛"
半导体制造是人类精密工程的巅峰。前道设备(光刻、刻蚀、薄膜沉积、离子注入等)的精度要求,直接决定了芯片的性能和良率。在所有的工业领域中,半导体设备对控制系统同步精度的要求是最苛刻的——没有之一。
纳米压印光刻:璞璘科技的突破
2025年8月,国产纳米压印光刻设备商璞璘科技宣布其PL-SR系列设备实现了<10nm的线宽分辨率。纳米压印是下一代光刻技术的重要候选方案,它不使用传统的光学透镜系统,而是通过物理模板直接在光刻胶上"压"出图案。
纳米压印对时间同步的要求极为苛刻。在压印过程中,模板与基板之间需要在纳米尺度上精确对齐——任何微小的时间偏差导致的相对位移,都会使压印图案失真。而且,纳米压印是"接触式"工艺,模板与基板之间的接触力和接触时间也需要精确控制,这同样依赖于高精度的时序管理。
长鑫存储G5平台:11.95nm的极限
长鑫存储的G5 DRAM平台采用了四重曝光技术(Quadruple Patterning),将有源区半间距推进到了11.95nm。四重曝光意味着同一个层需要曝光四次,每次曝光之间的套刻精度直接决定了最终图案的质量。
四重曝光的精度挑战在于"误差叠加":四次曝光每次都有套刻误差,四次误差的累积就是最终图案的偏差。如果每次曝光的套刻误差是σ,四次累积的误差就是2σ(RSS叠加)。对于11.95nm半间距的DRAM来说,每次曝光的套刻误差必须控制在2nm以内。这对控制系统的时间同步精度提出了极高的要求。
稳顶聚芯i-line光刻机:90nm套刻精度
稳顶聚芯的WS180i系列i-line光刻机,套刻精度
解锁后续 88% 内容