2026 工业“存储墙”白皮书:算力涨 60000 倍,带宽只涨 100 倍!为何 8 TOPS 的板子跑不过 4 TOPS,同一块板子帧率翻 3 倍?
2026-10-31 16:20:00
#CEO#CIO#设备动力总监#自动化研发总工#CISO (首席安全官)
序章:一块 4 TOPS 的板子,和一条永远喂不饱的数据线
2026 年秋天,长三角一家做精密结构件的工厂,一条视觉检测线停了三周。
停线的原因不是相机坏了,也不是模型不准,是节拍对不上。四路 1200 万像素相机,单件要求 80 毫秒,实测一百六十多毫秒。
集成商的第一反应很标准:算力不够。宣传册上印着 4 TOPS,那就换 8 TOPS。钱花了两倍,帧率几乎没动。
这个场景在 2026 年的工业现场反复上演。它不戏剧,也不上新闻,但它每年吞掉的集成预算,比任何一次芯片断供都多。
一个真实的工位,和一次错误的换板
把这件事拆开看,其实只有两个数:一个是那块板子的标称算力,一个是那块板子的内存带宽。
换板的时候,第一个数翻了一倍,第二个数一个字节都没变。
于是模型还是那么慢。因为在带宽受限的区间里,算力翻倍带来的有效吞吐提升是零,不是一半,不是两成,是零。
这不是经验判断,是可以在纸上算出来的。本篇第三章会把这道算术从头推到尾,读者可以自己拿计算器验一遍。
更麻烦的是,这个错误不会被复盘出来。项目验收时,大家看的是“模型跑起来了”,没人去追“为什么换了更贵的板子还是这个帧率”。
钱花出去了,教训没留下。下一次选型,同样的错再犯一遍。
消费者看到涨价,工厂看到静默
2026 年下半年,手机厂商集体涨价。小米、华为、荣耀多款机型上调 200 到 1000 元,iPhone 18 Pro 国行起售价上调 1000 元至 9999 元,官方把原因归给存储芯片行业性涨价。
消费者能感知到的,是“手机贵了”。
工业现场发生的是同一件事的静默版本。边缘盒子的内存成本在涨,但没人把它写进项目复盘。
原因很朴素:在工业项目里,内存通常只占整机物料成本的个位数百分比。真正贵的是“算力买够了、节拍上不去”造成的产线停摆与二次集成。
一台边缘盒子省 2GB 内存,按 2026 年三季度的报价是 24 美元。一条线停三周,损失是它的几百倍。
所以工业客户对内存涨价天然不敏感,对带宽不足却天然敏感——只是他们不知道自己在敏感什么。
这一篇只谈搬运
这一篇不谈“AI 让制造业变聪明”。这句话已经被说得太顺口,顺口到没人再追问它对应哪一行代码、哪一颗芯片。
这一篇只谈一件更朴素的事:数据从存储搬到计算单元的路上,到底损耗了多少你付过的钱。
搬运这件事,一半在硅片上,一半在代码里。只看硅片,你会以为必须换硬件;只看代码,你会以为软件万能。
本篇的每一章都会同时给出两侧的动作:硬件侧看位宽、看片上缓存、看封装、看近存;软件侧看算子融合、看图优化、看量化、看冷热分层、看缓存管理。
两条腿都短的时候,先迈哪一条,是有顺序的。这个顺序,第十五章会给出一个 36 个月的排法。
云质变判断
过去二十年,算力涨了六万倍,内存带宽只涨了一百倍。这条缝,就是 2026 年所有端侧 AI 项目的真实成本。
先记住这句话。后面十七章,都是在拆它。
第一章 六万倍与一百倍:二十年的账,为什么今天才来收
三条曲线拉开的速度不一样,账就一定会有人在某一天来收。
三条曲线,一条缝
过去 20 年,硬件峰值算力增长约 60000 倍。
同期 DRAM 带宽仅增长约 100 倍。互连带宽仅增长约 30 倍。
这三个数字出自中兴通讯《存算一体——重塑芯片架构新势力》(2026-08-24),原文表述是“硬件峰值算力增长了约 60 000 倍,而 DRAM 带宽和互连带宽仅分别增长 100 倍和 30 倍”。
把它们放在同一个对数坐标上,你会看到一条陡峭的线和两条几乎压平的线。中间那块越张越大的空白,就是今天所有端侧 AI 项目要付的溢价。
这条缝不是新出现的。它一直在扩大,只是过去十年里,算法还没大到必须穿过它。
推论也很直接:单纯增加计算单元无法带来等比例的性能提升,反而导致硅片利用率下降与能耗剧增。
换句话说,你买的算力越多,闲置的算力也越多。闲置的部分不省电,它照样发热。
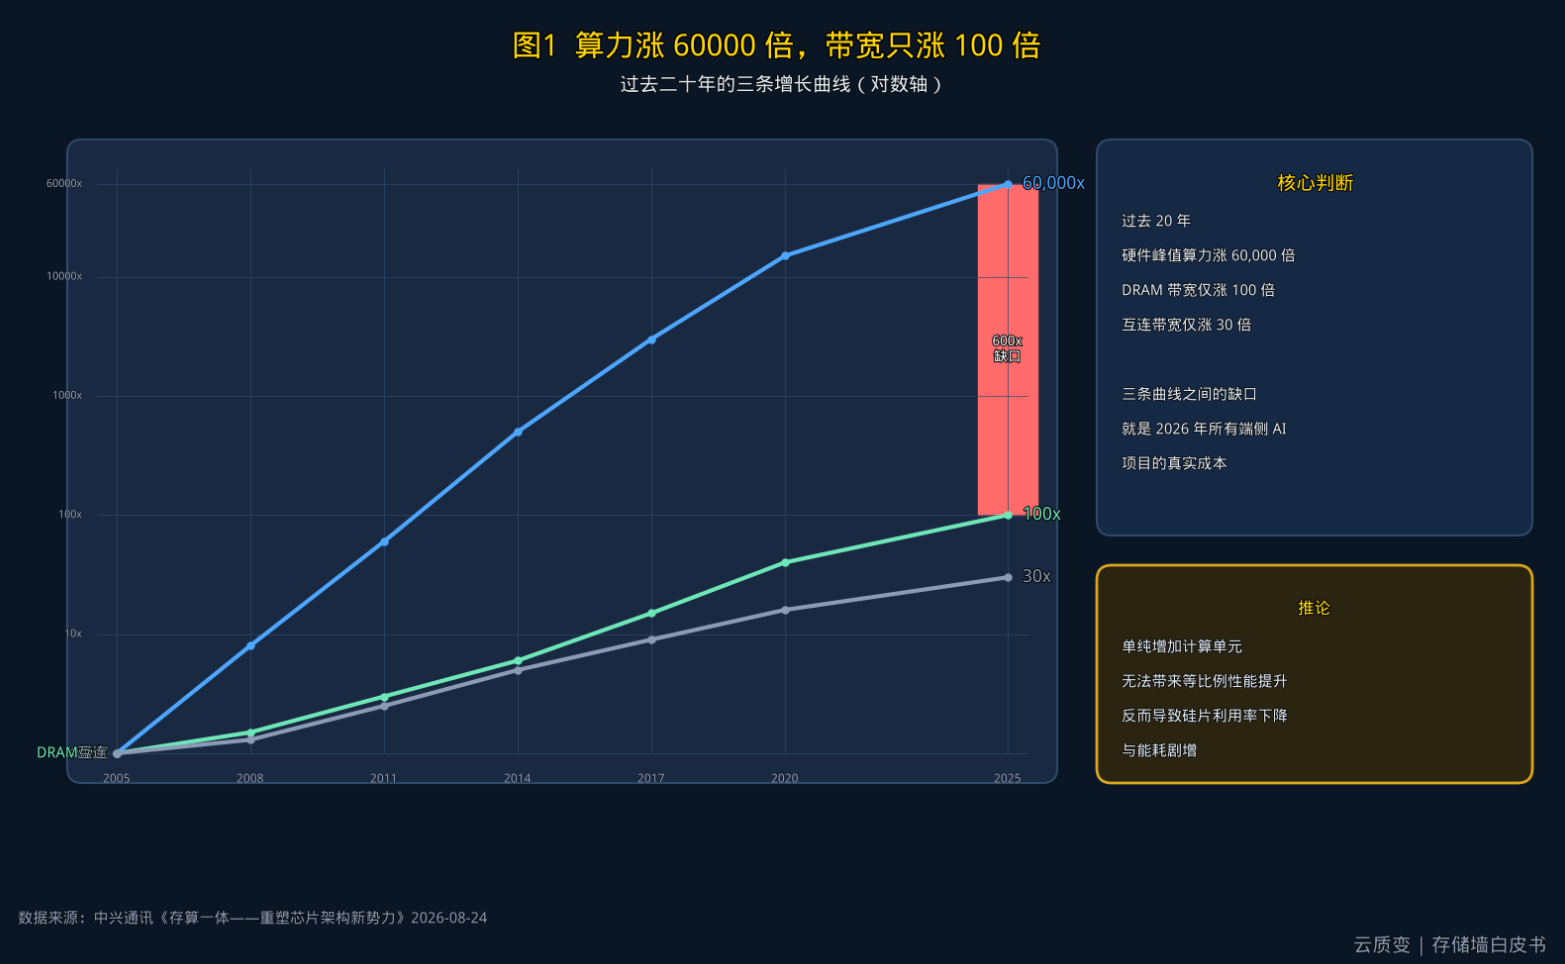
图 1 二十年剪刀差
这张图要看的不是三条线的斜率,是它们之间的夹角。夹角一旦形成,任何“再等两年硬件就好了”的期待都不成立。
带宽阶梯:从 85.6 GB/s 到 3.6 TB/s
判断一个平台能跑多快,有一个粗暴但极准的公式:tokens/sec 约等于 memory_bandwidth 除以 model_size_in_bytes。
这个公式只适用于大模型推理的 decode 阶段,也就是逐 token 生成的那一段。此时 batch 小,每生成一个 token 都要把全部权重读一遍,是典型的带宽受限。
对照 prefill 阶段,也就是处理输入 prompt 的那一段,矩阵乘密集,更接近 compute-bound,能吃满 Tensor Core。所以同一个模型,prefill 和 decode 的性能瓶颈根本不是一个东西。
按这个公式把主流平台排一遍,阶梯感非常强。
| 平台 / 介质 | 带宽 | 7B FP16(14GB)理论 tok/s | 7B Q4(3.5GB)理论 tok/s |
|---|---|---|---|
| 手机 LPDDR5X(Galaxy S26 / Exynos 2600) | 85.6 GB/s | 约 6.1 | 约 24.5 |
| LPDDR6(预计 2027 至 2028 年) | 约 200 GB/s | 约 14.3 | 约 57.1 |
| 数据中心 H100 HBM3E | 1.229 TB/s | 约 87.8 | 约 351 |
| HBM4(SK 海力士 16 层 48GB) | 大于 2 TB/s | 约 143 | 约 571 |
| HBM4E(三星 12 层) | 3.6 TB/s | 约 257 | 约 1029 |
手机与数据中心的带宽差是 1.229 TB/s 除以 85.6 GB/s,等于约 14.4 倍。业界常说的“14 倍”就来自这里。
这张表最值得注意的不是最后一列,是第二列和第三列之间的落差。同一块硬件,权重从 16 位压到 4 位,理论吞吐直接乘四。
这就是为什么第五章要花整整一章讲量化:它是这张表上唯一不需要换硬件的那个变量。
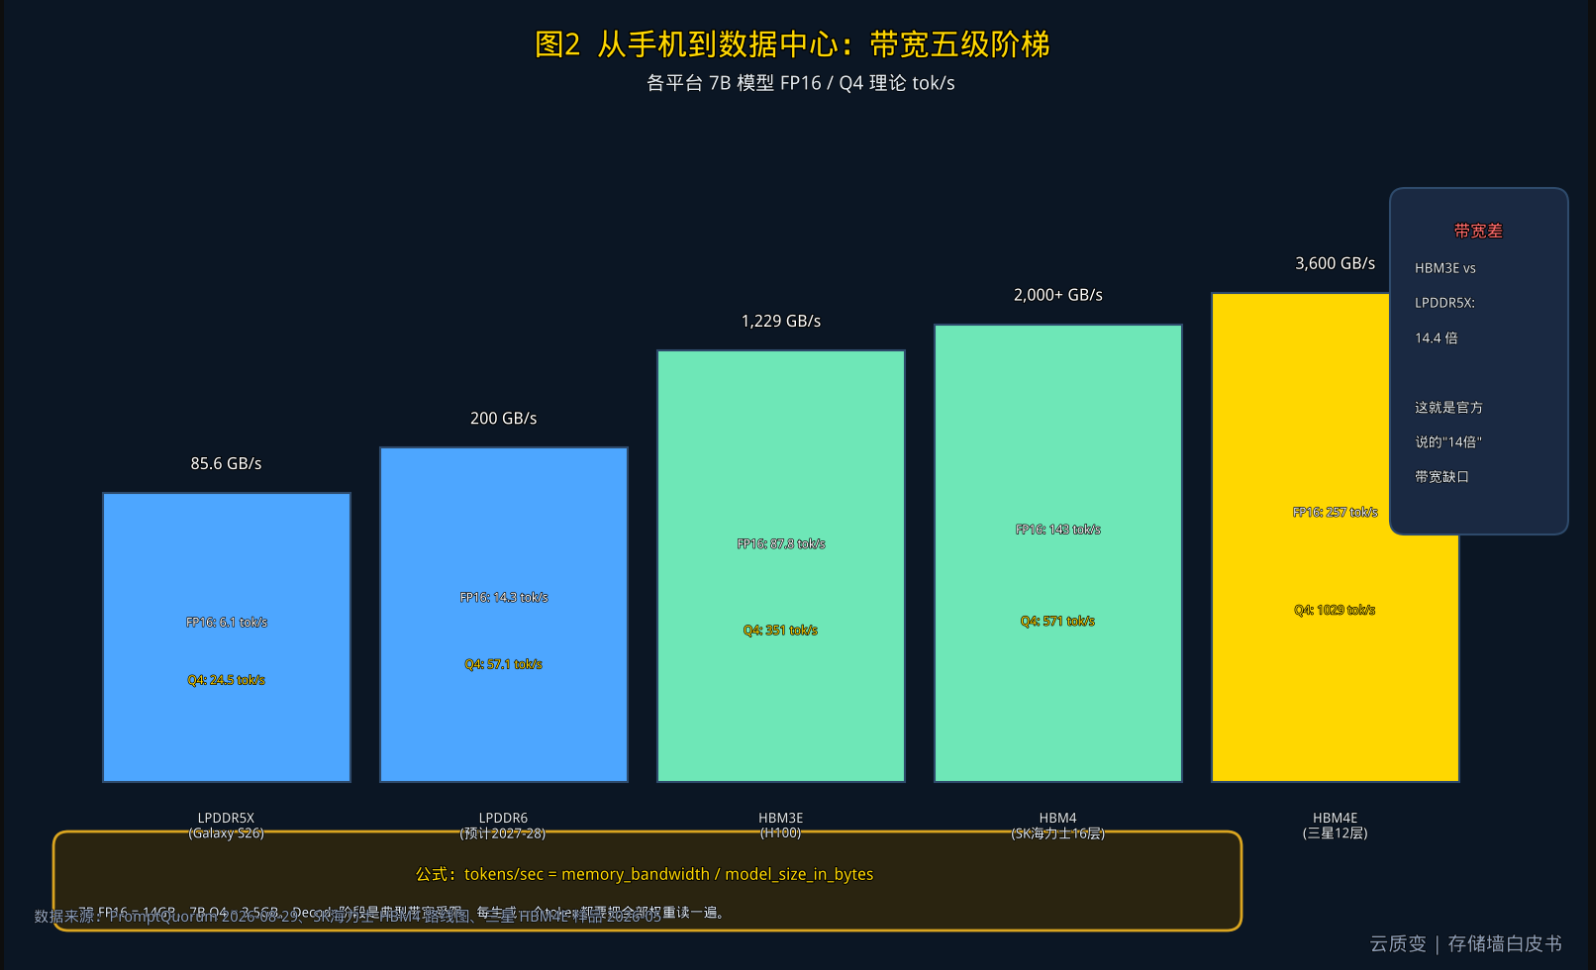
图 2 带宽阶梯
这里必须先把一个口径冲突说清楚,否则后面所有数字都会被误读。
厂商宣传的带宽是理论峰值,算法是速率乘位宽。实际可达带宽通常是理论值的 60% 到 80%,受刷新、行列切换、多主控争抢影响。
本篇在横向对比时统一采用理论峰值,因为只有峰值才是可比的公开口径。但凡涉及“能不能跑满”的判断,一律要打七折。
七折不是保守,是常态。任何把理论峰值当作可持续带宽去做容量规划的方案,都会在实测时崩掉,而且崩得毫无预兆。
所以看到“85.6 GB/s”这个数,工程上应该先在心里换成 60 GB/s 左右,再去算它能跑多少帧。
端侧的物理上限:1 到 2 GB
跑一个 7B 参数大模型,光把权重加载进内存就要占掉 14GB 以上。
而主流手机能分给单个应用的,只有 1 到 2GB。
这两个数字放在一起,不是“贵不贵”的问题,是“装不装得下”的问题。华邦电子把这个约束总结成容量、带宽、功耗的三角约束,三者相互牵制,动一个另两个就难受。
云质变判断
终端厂商面对的已经不是要不要多花钱的选择题,而是多花钱也未必装得下的物理上限。
终端厂商面对的已经不是“要不要多花钱”的选择题,而是“多花钱也未必装得下”的物理上限。
这句话放在工业现场同样成立,只是数字换了一套:一台两千元级的边缘盒子,内存 8GB,系统占一部分,数据库占一部分,剩下的才是模型和推理工作区。
很多项目在实验室里跑得好好的,一上产线就 OOM,原因不是模型太大,是实验室那台机器上没有数据库、没有远程管理 agent、没有视觉中间件。
所以“装得下”这三个字,必须在生产环境的进程清单里验证,不能在干净的容器里验证。
存储标准在往前走,但走得不快
移动端的存储标准这几年一直在推,节奏可以看得很清楚。
| 标准 | 关键指标 | 时间节点 |
|---|---|---|
| LPDDR5X | 美光等已实现 9.6 Gbps 峰值;Galaxy S26 Ultra 搭载 10.7 Gbps 版本 | 较初代 LPDDR5 的 6.4 Gbps 提升约 50% |
| LPDDR6 | JEDEC 2025 年 7 月发布标准,起始 10.667 Gbps,最高可达 14.4 Gbps 以上 | 2026 年是 LPDDR5X 性能巅峰期,同时是向 LPDDR6 平移的准备期 |
| UFS 4.0 / 4.x | 支持高达 4.3 GB/s 读取 | 2026 年主流旗舰核心存储方案 |
| UFS 4.1 | 铠侠已向客户送样,随机读取性能提升 90% | 2026 年在售 |
| UFS 5.0 | 理论速度翻倍至 10.8 GB/s,针对 AI 密集型数据访问路径优化 | JEDEC 2025 年末定案,2026 年首批送样,终端预计 2026 年底至 2027 年初面世 |
看这张表要有耐心,也要有不耐心。
耐心在于:LPDDR6 从标准发布到规模可用,中间隔着 SoC 平台换代,业界普遍预期是 2027 到 2028 年。
不耐心在于:如果你的项目今年就要上线,这张表上除了 UFS 4.1 的随机读提升,其余对你都没有意义。
一个必须记住的区分:UFS 决定启动有多快,DRAM 带宽决定跑起来有多快。这两个指标不能互相替代,第九章会专门拆这件事。
供给端的结构性挤压
需求侧在涨,供给侧在收,这是 2026 年存储市场的基本面。
集邦咨询的测算是,2026 年 HBM 和 RDIMM 预计将占 DRAM 供给位元的 51%。也就是说,超过一半的 DRAM 产能被高附加值产品拿走了。
原厂把有限先进产能持续向 HBM、服务器内存倾斜,通用 DRAM 与 NAND 的供给弹性被结构性压缩。2026 年 8 月,全球 DRAM 与 NAND 平均价格再创历史新高。
瑞银的预测更硬:2027 年存储芯片需求同比增长 36.2%,供给增速 19.3%,供需缺口从 2026 年的负 8.1% 扩大到负 13.6%,为近 30 年罕见水平,紧张格局将持续至 2028 年上半年。
SK 海力士 CEO 的表态最直白:存储短缺可能持续到 2030 年底。
对工业客户来说,这些宏观数字的意义只有一个:你不可能靠“等价格回落”来解决问题。等的成本,比涨的成本更高。
这一章的软硬分工
三条曲线的缺口,硬件侧能做的事其实有限:加宽位宽、加大片上缓存、换更快的介质、把存储搬到计算单元隔壁。
这四件事每一件都对应真金白银,而且周期以季度甚至年计。
软件侧能做的事反而更灵活:把算子融合起来,减少一轮搬运;把逐元素算子并进前一层,省掉一整次读写;把权重压到 8 位或 4 位,让同样的带宽喂饱更多计算。
这一章要留下的判断是:缺口是结构性的,补缺口的手段必须一半在硅片上,一半在代码里。
只盯硬件的团队,会在预算审批上卡死;只盯软件的团队,会在物理极限前撞墙。
第二章 算术强度:一个除法,就能判断你的项目死在哪
选型会上最没用的一句话是“这个模型挺大的”。有用的是:它的算术强度是多少。
一个除法就能定性
算术强度的定义是:每搬运一字节数据,能完成多少次运算,单位是 ops/byte。
判定方法只有一步:把芯片的算力与带宽比值算出来,作为分界线。算子的算术强度高于这条线,属算力受限;低于这条线,属带宽受限。
带宽受限时,加算力无效。这句话是本篇所有结论的地基。
为什么无效?因为瓶颈不在计算单元,在数据供给。计算单元在等数据,你给它配更多计算单元,只是让更多单元一起等。
这也是为什么很多 NPU 的实测利用率只有标称值的一到两成——不是编译器不行,是数据没送到。
算术强度这个概念不新,但在 2026 年的工业项目里,它还没成为选型会的第一页。这本身就是一个问题。
六类算子的算术强度谱
不同类型的算子,算术强度差着数量级。把常见几类排一遍,谁在线上谁在线下,一目了然。
| 算子类型 | 算术强度 | 瓶颈归属 | 优化手段 |
|---|---|---|---|
| 3 乘 3 卷积 | 高 | 算力受限 | 提高利用率 |
| 1 乘 1 卷积 | 中 | 混合 | 算子融合 |
| 深度可分离卷积 | 低 | 带宽受限 | 融合与量化 |
| 全连接层 | 很低 | 带宽受限 | 权重量化 |
| 注意力机制 | 低 | 带宽受限 | 分块与缓存 |
| 逐元素与激活 | 极低 | 带宽受限 | 与前层融合 |
这张表解释了一个长期困惑:轻量骨干网(大量深度可分离卷积)在 NPU 上常常跑不出理论加速比。
原因就在这里。深度可分离卷积把一次大卷积拆成两次小运算,FLOPs 降下来了,但访存量没同比例降。FLOPs 除以访存字节,算术强度反而更低。
所以“更轻的模型”在带宽受限的芯片上,未必跑得更快。这是一个反直觉但极其重要的结论。
逐元素算子单独执行时,几乎全部时间都在读写内存。融合进上一层,可以省掉一整轮搬运,收益往往比换芯片还大。
注意力类结构的键值缓存随序列长度线性增长,长序列在小带宽芯片上很快撞墙。这一条在第十一章还会再出现一次,因为 Agent 把它放大了一个量级。
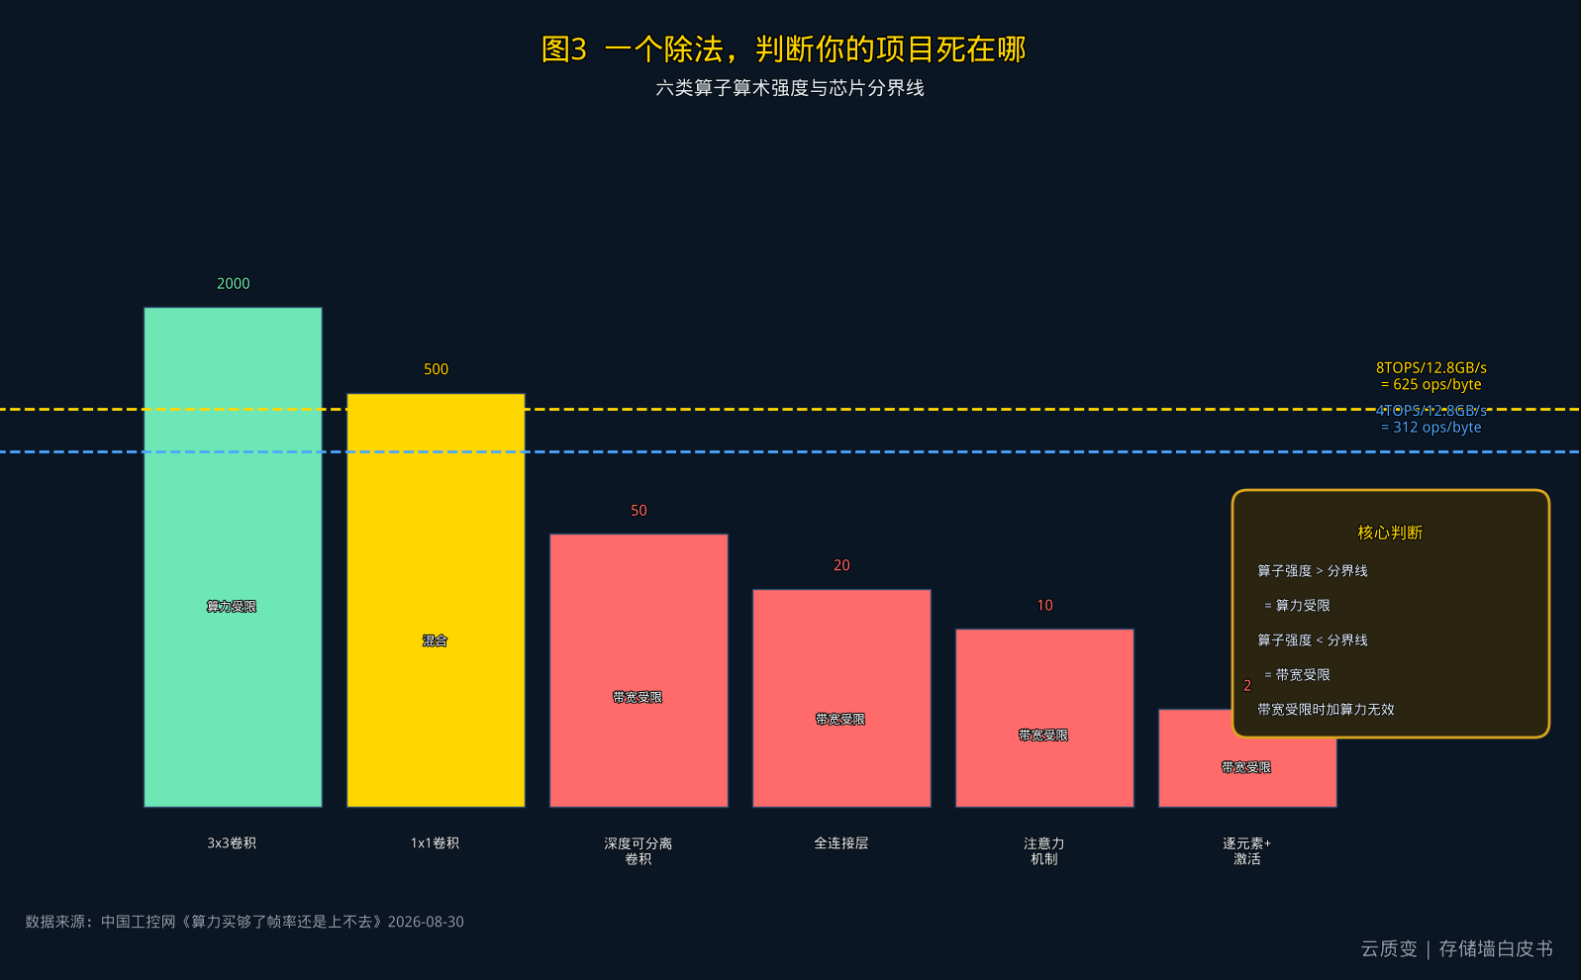
图 3 算术强度判据
分界线的算法:312 与 625
分界线的算法很朴素:芯片分界线等于标称算力(OPS)除以内存带宽(bytes/s)。
举两个真实的量级。4 TOPS 除以 12.8 GB/s,等于 4 乘 10 的 12 次方除以 12.8 乘 10 的 9 次方,得 312 ops/byte。
8 TOPS 除以 12.8 GB/s,得 625 ops/byte。
注意这两条线不一样。同一根内存总线,算力翻倍,分界线也翻倍。这意味着:算力越高的芯片,能落在“算力受限”区的算子越少,能落在“带宽受限”区的算子越多。
这就是“买更贵的芯片反而利用率更低”的数学根源。
工业边缘 SoC 的带宽实况是:常见产品的 DDR 带宽在每秒数 GB 到十几 GB 量级,而标称算力动辄数 TOPS。
按理论计算,低算术强度算子往往只能发挥标称算力的一到两成。这是实测帧率远低于宣传值的主因,不是个别厂商的问题,是整个品类的结构问题。
这里必须点破第二个口径冲突:TOPS 有三种口径,混用就会得出荒谬结论。
| 口径 | 含义 | 典型数值关系 |
|---|---|---|
| 峰值 TOPS(INT8) | 厂商宣传值,理想条件下测得 | 基准,1.0 |
| 有效 TOPS | 峰值乘以算力利用率 | 通常只有峰值的 10% 到 40% |
| 实测吞吐 | 单位帧每秒或 token 每秒 | 唯一可信的验收指标 |
三者不可混用。本篇第三章那个 0.64 TOPS 是有效算力,与厂商宣传的峰值算力根本不是同一个东西。
把 0.64 TOPS 和 8 TOPS 放在一起比较,就像把净重和毛重放在一起比较——数字都对,含义全错。
瓶颈定位四步法
知道原理之后,落地需要一套动作。下面这四步,任何一支工程团队一周内都能做完。
第一步,先测再改。用芯片 SDK 的性能分析工具拿到逐层耗时与访存量,不要凭经验猜。经验在带宽问题上几乎总是错的。
第二步,对比理论值。把逐层理论算力耗时与实测耗时对比,差距大的层就是带宽受限层。差距越大,越是瓶颈。
第三步,看 DDR 占用率。推理过程中 DDR 带宽利用率若长期高于 80%,说明带宽已是硬约束。这个阈值不是精确科学,但是一个非常好用的信号。
第四步,区分冷热。首帧包含权重加载,天然慢。稳态帧率才是产线节拍的依据,别用首帧数据做设计。
第四步最容易被跳过,也最容易造成灾难。用首帧帧率做选型,等于用冷启动数据定产线节拍。
优化手段的性价比排序
找到瓶颈之后,手段的选择有明确的价格梯度。下面这张表按“改动成本”从低到高排。
| 手段 | 典型收益 | 改动成本 | 风险 |
|---|---|---|---|
| 算子融合与图优化 | 明显 | 低 | 低 |
| 权重量化到 INT8 | 明显 | 中 | 精度小幅下降 |
| 降低输入分辨率 | 明显 | 低 | 小目标漏检 |
| 换轻量骨干 | 中 | 中 | 需重训 |
| 增大片上 SRAM | 明显 | 高 | 需换料 |
| 加宽 DDR 位宽 | 明显 | 高 | 成本与功耗上升 |
这张表要按顺序读,不要跳。
图优化与量化应该先做完,再讨论换芯片。很多项目在这一步就把帧率救回来了,省下的不只是芯片钱,还有重新做 EMC 与温升验证的几个月。
换料属最后手段,涉及重新做 EMC 与温升验证,周期以月计。产线停着等料的时候,这个“以月计”会变成很难看的东西。
输入分辨率是最容易被忽视的杠杆,改动成本低、收益明显。但工业检测降分辨率会牺牲小缺陷召回率,必须与质量部门确认,不能由算法团队单方面决定。
增大片上 SRAM 和加宽 DDR 位宽都是硬件动作,收益确定,代价也确定。区别在于前者只改芯片选型,后者要改整个板级设计。
这一章要留下的东西
如果只能从这一章带走一句话,那就是:先算除法,再谈预算。
算力除以带宽,得到一个数;模型逐层算术强度,得到另一组数。两组数一比,你就知道钱该花在哪一侧。
这个过程不需要买任何设备,只需要一张规格书和一台能跑 profiler 的机器。
它也不会花掉一个季度,只会花掉一个下午。
第三章 0.64 TOPS:加钱买算力的数学破产
“加钱买算力”这件事,在带宽受限的区间里不是低效,是无效。
算例设定:两块板子,一根总线
为了让这道算术可以被任何人复算,先把假设摆干净。
芯片 A:标称 4 TOPS,DDR 带宽 12.8 GB/s,价格设为 1 倍基准。
芯片 B:标称 8 TOPS,DDR 带宽同为 12.8 GB/s,价格约为 A 的 2 倍。
目标模型:以深度可分离卷积为骨干的轻量检测网络,平均算术强度取 50 ops/byte。
为什么取 50?因为深度可分离卷积的典型区间是 20 到 50 ops/byte,取上限对芯片有利,也就是让结论站在“尽量证明加算力有用”的一侧。
如果取上限都能证明无效,取中位数只会更无效。
把四个数并排放一遍:芯片 A 的分界线是 312 ops/byte,芯片 B 的分界线是 625 ops/byte,目标模型的平均算术强度是 50 ops/byte,相对价格是 1.0 对 2.0。
注意这两个分界线:312 和 625,都远高于模型的 50。也就是说,两块芯片都稳稳落在带宽受限区。
这就是这道算术成立的前提,也是它唯一的边界。后面会专门说什么时候不成立。
完整推导:为什么是 0.64
推导只有两步。
带宽受限时,实际吞吐等于带宽乘算术强度,与标称 TOPS 无关,只要标称 TOPS 高于这个值。
芯片 A 的有效算力等于 12.8 GB/s 乘 50 ops/byte。
单位先统一:12.8 GB/s 是每秒 12.8 乘 10 的 9 次方字节;乘 50 ops/byte,得每秒 640 乘 10 的 9 次方次运算,即 640 GOPS。
640 GOPS 就是 0.64 TOPS。
芯片 B 的有效算力同样是 12.8 GB/s 乘 50 ops/byte,同样等于 640 GOPS,同样等于 0.64 TOPS。
因为带宽没变,算术强度没变,乘出来的结果不可能变。
| 指标 | 芯片 A | 芯片 B | 差异 |
|---|---|---|---|
| 标称算力 | 4 TOPS | 8 TOPS | 翻倍 |
| 有效算力(带宽受限) | 0.64 TOPS | 0.64 TOPS | 0 |
| 标称算力利用率 | 16.0% | 8.0% | 减半 |
| 价格 | 1.0 | 约 2.0 | 翻倍 |
| 单位有效算力成本 | 1.0 | 约 2.0 | 翻倍 |
结论一行就能写完:标称算力翻倍,有效算力提升为 0,价格翻倍。
这不是近似,是恒等式。带宽相同、算术强度相同,乘积必然相同。
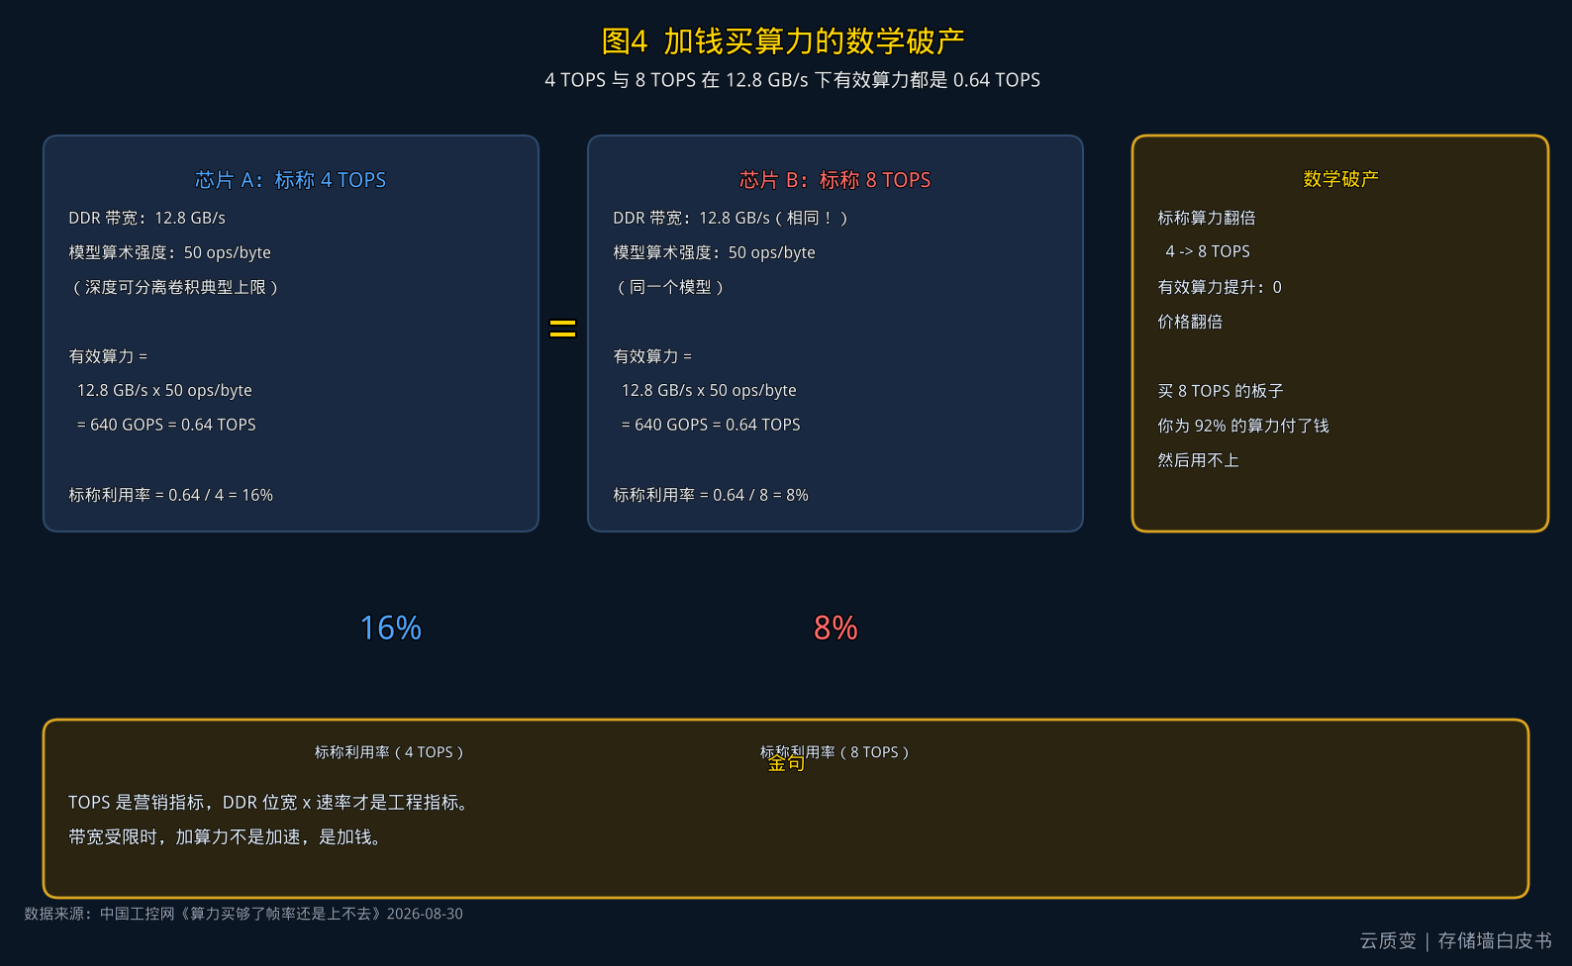
图 4 0.64 TOPS
利用率 16% 与 8%
利用率这一行更值得看。
芯片 A 的标称算力利用率等于 0.64 除以 4,等于 16.0%。
芯片 B 的标称算力利用率等于 0.64 除以 8,等于 8.0%。
换句话说:买 8 TOPS 的板子,你为 92% 的算力付了钱,然后用不上。
这 92% 不是“暂时用不上”,是“在这个模型上永远用不上”。除非你换模型,或者换带宽。
更荒诞的是,这块更贵的板子还要为那 92% 的闲置算力付电费。闲置的晶体管不会因为不干活就不漏电。
所以“加钱买算力”在带宽受限时是双重损失:一次在采购单上,一次在电费单上。
云质变判断
一块 4 TOPS 的板子只能发挥 0.64 TOPS,一块 8 TOPS 的板子还是 0.64 TOPS——你为另外 92% 付了钱,然后用不上。
边界条件:什么时候加算力是对的
这一节必须写,否则上面那道算术就成了教条。
该结论仅在带宽受限区间成立。若模型算术强度高于芯片分界线,比如 3 乘 3 卷积密集的重骨干网络,加 TOPS 是有效的,而且效果可能很好。
若模型本身很轻、单帧数据量很小,也可能落在算力受限区间。此时瓶颈在计算单元,加带宽没用,加算力有用。
所以第一步永远是测算术强度,不是买芯片。这个顺序错了,后面全错。
还有一个容易被忽略的情形:batch 变大时,算术强度会上升。同样的模型,batch 从 1 加到 8,权重可以复用,每字节搬运对应的运算次数变多,瓶颈可能从带宽侧滑向算力侧。
工业视觉通常是 batch 1 或很小的 batch,因为要低延迟。这恰恰是把项目推向带宽受限区的原因。
如果你为了提吞吐去加大 batch,延迟会上去,节拍会崩。这是一个真实的取舍,不是可以两头都要的好事。
一句必须写进正文的话:TOPS 是营销指标,DDR 位宽乘速率才是工程指标。
云质变判断
TOPS 是营销指标,DDR 位宽乘速率才是工程指标。
采购单上必须问的三个数
把上面的分析压缩成采购动作,只有三个数要问。
第一,DDR 位宽与速率。据此算出带宽 GB/s。如果供应商只给“LPDDR5”这样的型号不给位宽,那就等于没给。
第二,片上 SRAM 容量。它决定能缓存多少中间结果,减少往返搬运。这一项在规格书里常常藏在很小的字里。
第三,目标模型在该芯片上的实测稳态帧率与功耗。不是首帧,不是 demo 视频,是你自己的模型在你的分辨率下的稳态值。
这三个数要不到,就别签。要得到,前面那道除法你自己就能算。
顺便说一句,很多供应商其实愿意给。他们不给,是因为从来没人问过。
这一章的方法论意义
0.64 TOPS 这个数字,本身没有多重要。它只是 12.8 乘 50 的乘积。
重要的是它示范了一种思维方式:在掏钱之前,先用两个数做一次乘法,看看这笔钱会变成什么。
工业项目里最贵的错误,不是选错了方案,是在没算之前就选了方案。
这道算术花五分钟,能省两倍预算。这是本篇里性价比最高的一段。
第四章 工业现场的墙更硬:相机先吃掉三分之一带宽
消费电子的带宽是先给模型的,工业现场的带宽是先给相机的。
相机先吃掉带宽
先把数据流算清楚。
单帧 1920 乘 1080、8 位灰度,约 2 MB;30 fps 下约 60 MB/s,这还不含协议开销。
RGB 三通道,像素负载三倍。
1200 万像素(4000 乘 3000)、8 位灰度,单帧约 12 MB。
四路 1200 万像素、30 fps、灰度:12 MB 乘 30 乘 4,等于 1.44 GB/s。
若为 RGB:三倍,等于 4.32 GB/s。
若 DDR 带宽为 12.8 GB/s,仅相机原始数据即占用 11.3%(灰度)至 33.8%(RGB)。
三分之一。这个数字要在选型会开始之前就摆在桌上。
因为它是分母的一部分,而且是最先被吃掉的那部分。模型还没开始跑,带宽已经少了三分之一。
云质变判断
带宽不是被模型吃掉的,是先被图像吃掉的。
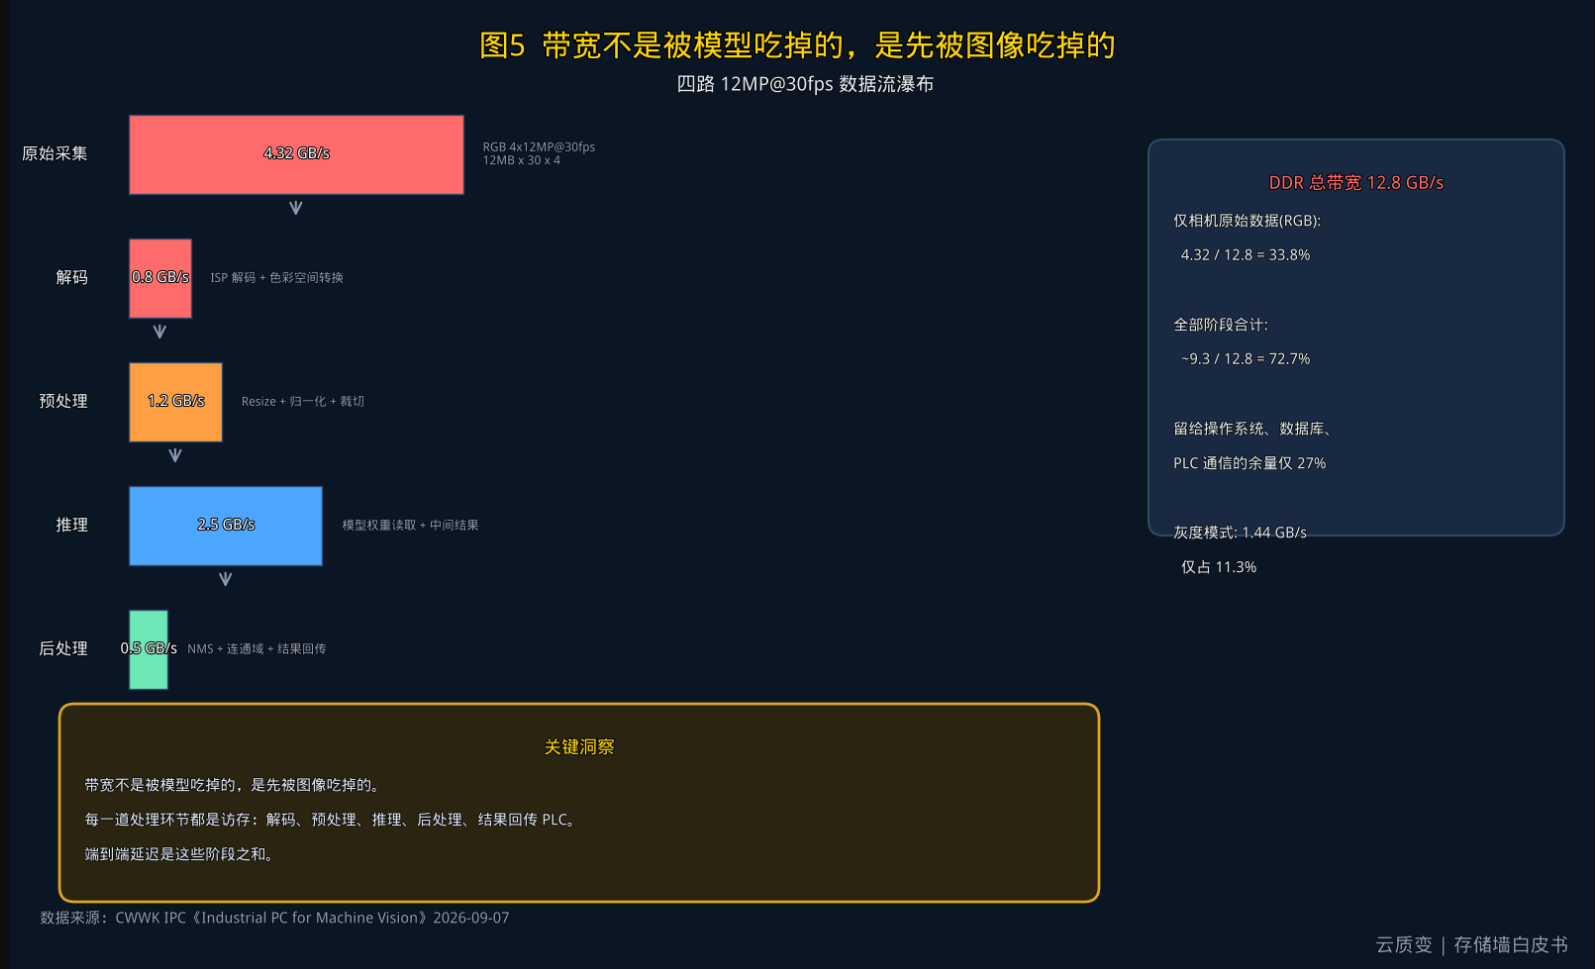
图 5 相机吃带宽
一条链路上的六道访存
相机只是第一道。一条完整的视觉检测链路,每一道都是访存。
解码:从相机协议缓冲搬到应用内存,一次写一次读。
预处理:resize、归一化、色彩空间转换,每一步都是读一遍写一遍。很多实现里 resize 和归一化是分开两次 pass,等于多搬一轮。
推理:模型权重与中间特征图往返片上缓存与 DDR。
后处理:NMS、连通域分析,通常是 CPU 侧,访存模式还很随机。
结果回传 PLC:数据量小,但延迟敏感,而且经常被忽略在延迟预算之外。
端到端延迟是这些阶段之和,不是推理那一段的耗时。这一点在项目复盘时经常被搞错。
所以“模型推理 40 毫秒”这个数字,对产线节拍几乎没有意义。有意义的是从触发到 PLC 收到结果的总时间。
| 阶段 | 访存特征 | 常见优化 |
|---|---|---|
| 原始采集 | 连续写,量大 | 降位深、ROI 裁剪 |
| 解码 | 一次写一次读 | 零拷贝、DMA 直通 |
| 预处理 | 多次读写,可融合 | 融合 resize 与归一化,单 pass |
| 推理 | 权重与特征图往返 | 算子融合、量化、片上缓存 |
| 后处理 | 随机访问,CPU 侧 | 下采样后再做 NMS |
| 回传 PLC | 小包、低延迟 | 独立线程与优先级 |
这张表最有用的一行是预处理。它是软件侧收益最高、改动最小、最容易被跳过的一段。
把 resize、归一化、色彩空间转换合成一个 kernel,很多项目能省下 10% 到 20% 的端到端时间,成本是几天开发。
系统内存与加速器内存是两个瓶颈
这是工业现场最容易搞混的一件事。
系统 RAM 承载操作系统、解码帧、应用数据、数据库、CPU 侧模型缓冲。
加速器 VRAM 或共享内存承载模型权重与推理工作数据。
一台显存很大但系统内存不足的机器,会在预处理阶段卡死;反过来,系统内存充足但显存带宽窄的机器,会在推理阶段卡死。
两种卡死的现象都是“帧率上不去”,但解法完全不同。一个是加内存条,一个是换加速器。搞错了就是白花钱。
云质变判断
一台显存很大但系统内存不足的机器,会在预处理阶段卡死;反过来,系统内存充足但显存带宽窄的机器,会在推理阶段卡死。
容量参考也有一条经验线:16 GB 可处理较轻视觉或传感推理;32 GB 是多服务边缘 AI 的实用基线;多相机、更大模型、本地数据库或 LLM 级负载需要 64 GB 以上。
注意“本地数据库”这四个字。它经常是压垮 16GB 配置的最后一根稻草,而它在 POC 阶段通常不存在。
三档配置与真实价格带
把负载分成三档,配置方向就清楚了。
| 档位 | 典型负载 | 硬件方向 |
|---|---|---|
| 边缘网关加轻 AI | 传感分析、单个轻模型 | 低功耗 CPU 或 NPU,16 GB,双网口与串口 |
| 视觉边缘机 | 1 到 4 路相机,检测与 OCR | 较强 CPU 加集成或独立加速器,32 GB,NVMe |
| 高性能边缘 AI | 多相机、多模型、大型视觉语言模型 | 桌面级 CPU 或 GPU,64 GB 以上,10GbE,强 PCIe 与散热 |
三档之间的价格差是断层的,不是渐变的。2026 年 10 月阿里巴巴国际站的报价可以说明这一点。
RK3588 边缘计算盒 8GB 内存,人民币 1641 到 1747 元。
RK3588、RK3576、RK3399 全封闭 AI 边缘盒,6 TOPS NPU,1864 到 2605 元。
Jetson AGX Orin 32GB 或 64GB 边缘 AI 盒,200 或 275 TOPS,25811 到 39047 元。
关键对照:6 TOPS 盒子两千元级,200 TOPS 盒子两万五千元级,价格差 12 倍,标称算力差 33 倍。
这个非线性关系本身就是“算力不是唯一变量”的市场证据。如果算力是唯一变量,价格应该和算力同比例涨,而不是只涨三分之一。
差额去哪了?去了带宽、去了内存容量、去了封装与散热。买贵板子的人,买的主要不是算力。
验收测试:把数据库和 PLC 一起打开
这一节是全篇最可执行的一段,也是最容易被跳过的一段。
上线前,让每一路计划中的相机在生产分辨率与帧率下连续跑数小时。
记录五项:丢帧数、端到端决策延迟、CPU 与 GPU 利用率、温度、存储写入量。
然后做一件很多人不做的事:在数据库、远程管理 agent、PLC 通信服务同时运行时重复测试。
只有这样才能暴露单模型 benchmark 漏掉的资源争抢。内存带宽是共享资源,数据库的一次大查询就能让你的推理帧率掉三成。
这个现象在实验室永远复现不了,因为实验室里没装数据库。
8 小时是下限,不是目标。产线的班次是 8 小时,测试至少要覆盖一个完整班次,最好覆盖一次交接班。
温度也要看。边缘盒子装在电控柜里,柜内温度比车间高十度是常态。规格书上的性能是在 25 度下标称的。
第五章 量化的真相:你省的不是精度,是带宽
把权重从 16 位压到 4 位,是 2026 年唯一一个不花钱就能把帧率乘四的动作。但大多数人做错了方向。
量化省的不是精度,是带宽
很多人做量化,动机是“听说 INT4 能提速 3 倍”。跑起来发现,要么精度掉得像筛子,要么速度没涨多少,甚至更慢。
根因是把量化当“压缩 zip”用了——以为把权重从 16 位压到 4 位就结束了。
实际上,量化只是第一步。真正的三倍来自一条链:更小的权重 footprint,导致更少的显存读,于是同张卡能开更高压的 batch 或更长上下文,最后再由专用低比特 GEMM kernel 把 Tensor Core 吃满。
这条链上任何一环断了,收益就落不到你手上。这就是为什么有人量化完速度没变:他换了权重格式,但 kernel 还是按 16 位在跑。
所以这句话要写得更准确一点:量化省的不是精度,是带宽。它把“每生成一个 token 要读多少字节”这个数变小了。
而 decode 阶段的时间,几乎完全由这个数决定。
云质变判断
量化省的不是精度,是显存带宽。
四种精度格式的账
先看体积账,因为体积就是带宽。
| 格式 | 每权重占位 | 70B 显存(近似) | 7B 显存(近似) | 适合谁 |
|---|---|---|---|---|
| FP16 | 16 bit,约 2 B/param | 约 140 GB | 约 14 GB | 有多卡 |
| INT8(W8A16) | 约 1 B | 约 70 GB | 约 7 GB | 稳定、几乎无损 |
| INT4(W4A16) | 约 0.5 B(有效 4 到 5 bit,含分组缩放) | 约 35 到 40 GB | 约 3.5 GB | 生产性价比最高 |
| GGUF Q4_K_M | 有效约 4.5 到 4.9 bit | 同上量级 | 同上量级 | 本地、Mac、消费卡 |
注意 INT4 那一行的括号:有效 4 到 5 bit,含分组缩放。这意味着它不是“精确的四分之一”,实际压缩比略低于 4。
Q4_K_M 更明显,有效 4.5 到 4.9 bit。所以工程上算收益时,按 3.5 到 4 倍算比按 4 倍算更安全。
分组缩放(group-wise scaling)这件事值得多说一句:它给每组权重配一个缩放因子,用少
解锁后续 88% 内容