2026 工业 AI“验收”白皮书:准确率 99%,同一个零件测三次两个答案!六行验收单,三行没人敢签
2026-11-10 15:41:00
#CEO#CIO#设备动力总监#自动化研发总工#CISO (首席安全官)
序章:一个通过了 FAT、死在了 SAT 的项目
0.1 现场:八项 FAT 全绿
浙江一家压铸厂,2026 年 3 月,一套视觉质检系统在供应商的实验室里通过了全部八项 FAT。
八项测下来,没有一项返工。准确率 99.2,320 件样品全绿,单件检测 0.42 秒,比合同写的 0.5 秒还快。
验收报告一共 26 页。第 3 页是样品清单,第 7 页是准确率曲线,第 19 页是八项 FAT 的逐项签字。
签字的人有四个:供应商项目经理、供应商算法负责人、买方设备部工程师、买方采购。
会议室的灯是均匀的,桌面是白色的。样品是供应商从买方现场挑回来的,好件和坏件一共 320 件。
买方设备部工程师后来回忆,那天他唯一觉得不对的地方,是样品太干净了。
干净到什么程度?没有油膜,没有脱模剂残留,没有料饼毛刺,没有一模一样的飞边。都是能从车间挑出来的件,但挑的时候被人用手擦过。
这句话在当时不重要。320 件全绿,八项全过,没有人会为一个“太干净”去否掉一份 26 页的报告。
0.2 运到现场:灯、油雾、节拍
系统 4 月 12 日到场,4 月 19 日通电,4 月 26 日开始跟线。
车间和实验室的差别,第一周就全露出来了。
第一条是灯。车间顶灯是 12 米高的高棚 LED,八小时周期内有可测的光强漂移;实验室是均匀面光源,漂移小于一个百分点。
第二条是油雾。压铸机开模瞬间有油雾逸出,油雾在镜头保护镜上结膜,一个班下来透光率就变了。
第三条是振动。相邻工位是 400 吨压铸机,合模冲击传过来,相机支架跟着抖,像素级偏移在标定值之外。
第四条是节拍。实验室是单件上料,现场是每分钟 28 件,日产能 4.2 万件。
这四条差异,一条都没写在 FAT 的 26 页报告里。
不是供应商隐瞒,是 FAT 的定义里就没有这四项。FAT 验的是“机器按规格被造出来了”,它不验“在你的厂里能不能用”。
0.3 第三周:操作员关掉了自动剔除
第一周,误检率还在可接受范围。第二周开始往上走。
第三周,一名班组长做了一件在制造业极常见、在所有合同里都没有对应条款的事:他把自动剔除关了。
理由很朴素。一个班 8 小时,系统每天报警两百多次,其中真正需要处理的不到一成。操作员每次都要停下来看一眼,看一眼 40 秒。
关掉之后,产线恢复原来的节奏,人工复检照旧。
系统还在跑。屏幕上还在出框。只是没有人再按它的结论执行。
这件事在数据上几乎看不出来。日志里没有“关闭”这个事件,只有“剔除执行次数”从每天 300 次降到 0。
四个月后复盘,供应商的第一反应是“客户没用起来”,客户的第一反应是“系统不准”。两边都没有说错,两边也都没有说到点上。
0.4 项目没死,它变成了辅助提示系统
这个项目最后没有失败,也没有成功。
验收单签了,功能上线了,效果没人认领。
供应商说,系统稳定运行,准确率 99.2,符合合同。买方说,我们还在用人工复检,AI 只是提示。财务说,这个项目没有产生可计量收益,所以不进损益表。
三句话都是真的。
于是它变成了一种很常见的东西:辅助提示系统。挂在产线上,开着,没人看,但谁也不能说它没用。
这就是本篇要讲的事。一个技术上做出来了的系统,是怎么在验收这一步变成“辅助提示”的。
请注意,问题不出在算法。320 件全绿是真的,99.2 也是真的。问题出在,从头到尾没有人拿尺子量过它在车间里的样子。
准确率不是尺子。它是供应商在自己选的样品上、自己定的口径下,给出的一个数。
云质变判断
准确率不是尺子。它是供应商在自己选的样品上、自己定的口径下,给出的一个数。
第一章 四个数字,四道门
1.1 四个数字,四套分母
2026 年,关于工业 AI 有四个数字被反复引用:百分之九十二、百分之八十八、百分之八、百分之六。
这四个数字经常被并排放在同一张 PPT 上,用来讲同一个故事。它们讲的其实不是同一个故事。
它们的口径完全不同,分母完全不同,样本完全不同。
表 1 四个数字的并列口径
| 数字 | 含义 | 分母 | 出处 |
|---|---|---|---|
| 百分之九十二 | 已开展 AI 试点 | 中国工业企业 | 德勤中国加港大,2026-10-27 |
| 百分之八十八 | 概念验证从未进入生产 | 企业 AI 概念验证 | IDC,2026-09-10,经 bex.co 引用 |
| 百分之八十六至八十八 | AI Agent 试点未毕业到生产 | AI Agent 试点 | Forrester 加 Anaconda,2026-09-06 |
| 百分之八 | 获得财务战略收益 | 已开展试点的企业 | 德勤中国加港大,同上 |
| 百分之六 | 高绩效者,AI 贡献至少五个百分点 EBIT 且影响显著 | 使用 AI 的企业 | 麦肯锡 State of AI 2026,样本 1719 人 |
| 百分之四十一 | 进入生产的试点,12 个月后 ROI 为负 | 进入生产的试点 | Forrester,2026-09 |
| 百分之四十六 | 在 POC 与广泛采用之间被砍掉 | AI 项目 | S&P Global,样本 1006 人 |
| 百分之八十 | 无法跨越试点阶段 | AI 项目 | BCG,2026 |
数字本身没错。错的是把它们放在一句话里。
百分之九十二的分母是“中国工业企业有多少家开始做”,百分之八的分母是“已经开始做的里面有多少家拿到钱”。分子分母都不在一层楼。
1.2 断崖不在开始,在结算
把这四个数字按顺序摆开,看它们怎么掉。
从百分之九十二到百分之八十八,掉了四个点。
从百分之八十八到百分之八,掉了八十个点。
从百分之八到百分之六,掉了两个点。
掉得最狠的那一段,不在“开始”,也不在“验证”,在“验证通过之后到产生财务收益”这一段。
这一段的名字,叫验收与结算。
这也是本篇要盯住的那一段。因为前面两段已经被讨论烂了:怎么立项、怎么搭模型、怎么做 POC,方法论一抓一大把。而“验证通过之后到拿到钱”这一段,方法论几乎是空的。
空到什么程度?一个项目验收通过了,账上确认了收入,客户那边没有任何一条产线指标发生变化。这件事在工业 AI 里是常态,不是例外。
云质变判断
从九十二到八十八掉了四个点,从八十八到八掉了八十个点。断崖不在开始,在结算。
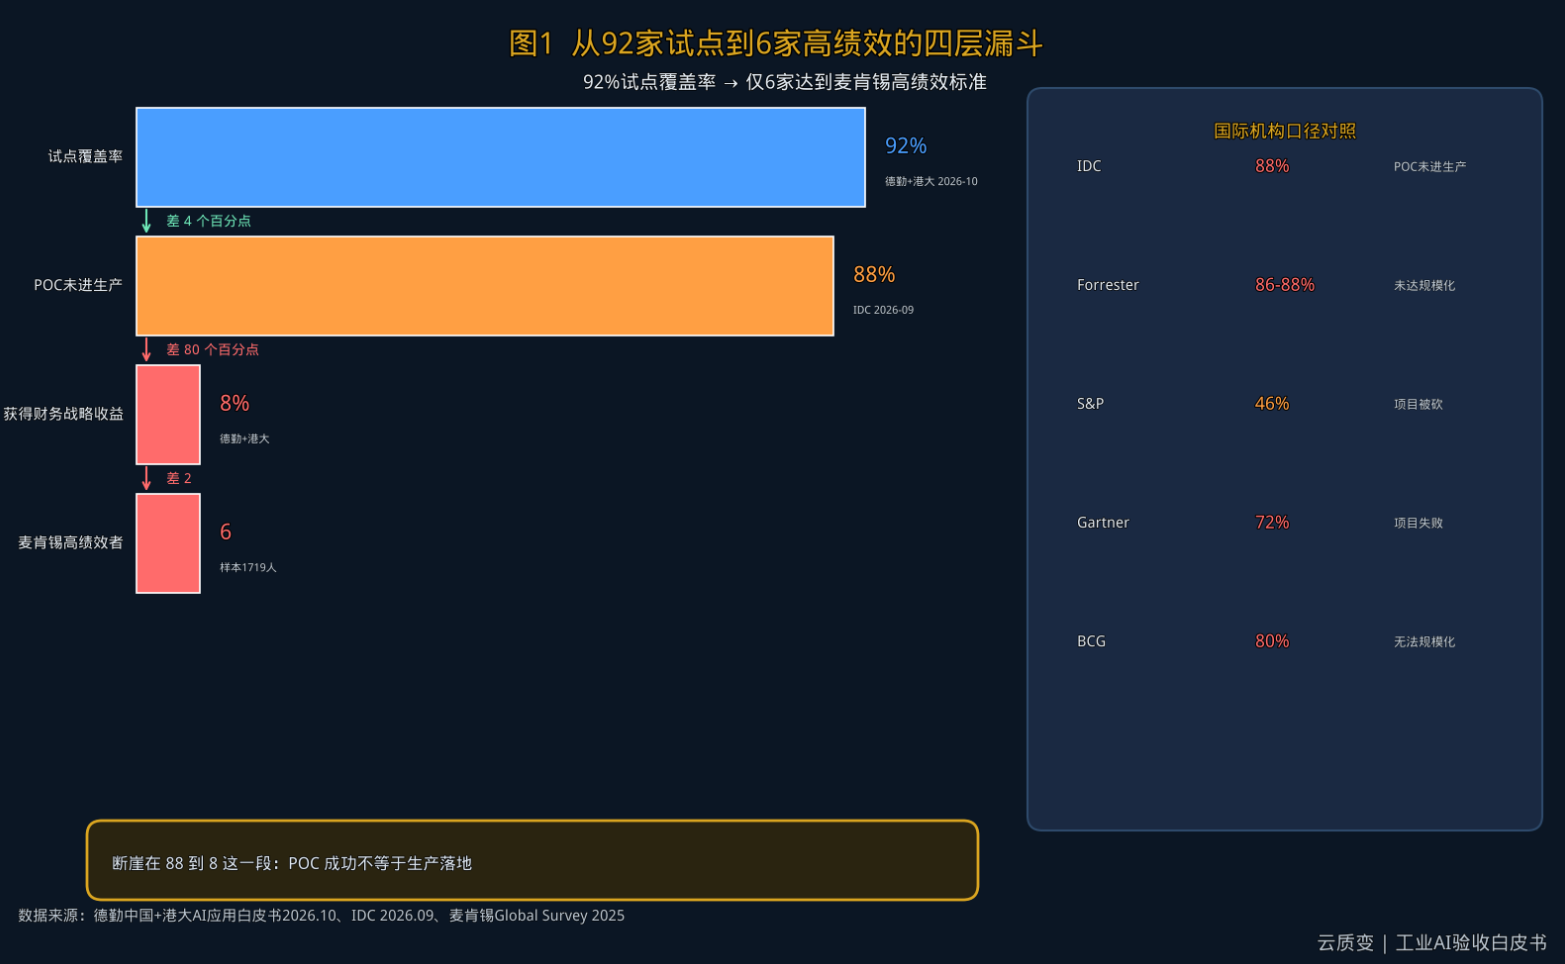
图 1 从 92 家试点到 6 家高绩效的四层漏斗
这张图要说明的是:四层漏斗的收口位置不在最上面,而在第三层到第四层之间;国际口径并排放着看,IDC 的百分之八十八、Forrester 的百分之八十六至八十八、麦肯锡的百分之六、BCG 的百分之十,落点全部集中在同一段。
1.3 一个必须承认的反面事实
IDC 把百分之八十八这个数字归因于“数据、流程、IT 基础设施的组织准备度不足”,而不是模型质量。
这个归因和 050 那篇的结论一致:模型从来不是最难的部分。
但 IDC 的归因停在“准备度不足”这一步,没有再往下问。
本篇要往前推一步:准备度不足之所以长期无法改善,是因为没有一个验收标准能告诉企业“准备到什么程度算够了”。
没有终点线的跑道,跑的人不会加速,只会绕圈。
这句话可以反过来验证。过去三年,模型能力涨了不止一个数量级,标注工具、推理框架、边缘算力全都在降本,而失败率还在百分之八十附近。如果瓶颈在准备度,那准备度应该跟着工具一起变好。
它没有变好。因为没有人定义过“好”是什么。
1.4 四道门的命名
工业界对物理设备有一整套门。这套门有名字,有顺序,有签字人。
第一道门叫 FAT,验机器造得对不对。
第二道门叫 SAT,验在你的车间里能不能用。
第三道门叫 PPAP,验量产件能不能交付。
第四道门叫 MSA,验量具能不能分辨零件。
四道门后面还有一个 Cpk,验过程能不能稳定产出合格品。
对模型,这四道门一道都没有。
没有 FAT,因为模型的“出厂测试”是供应商在自建测试集上跑的分,样本由供应商选、标注由供应商做、阈值由供应商定。
没有 SAT,因为绝大多数 AI 项目不做现场验收测试,或者把“上线跑两周看看”当成 SAT。
没有 PPAP,因为模型没有“量产件批准”的概念,版本升级不需要重新走批准流程。
没有 MSA,因为 AI 质检系统从来不报 GRR 占比。
四道门全部空缺。于是项目只有一条路可走:把 FAT 的结论直接当成 SAT 的结论,把供应商实验室的数字直接写进合同。
序章那个压铸厂,走的就是这条路。
第二章 验收:被跳过的那道门
2.1 工业界对物理设备的五级验收
先把成熟体系摆出来,因为后面所有的对比都要用到它。
表 2 工业界对物理设备的五级验收
| 环节 | 全称 | 验什么 | 依据 |
|---|---|---|---|
| FAT | 工厂验收测试 | 机器造得对不对 | 合同加供应商实验室 |
| SAT | 现场验收测试 | 在你的车间能不能用 | 合同加买方现场 |
| PPAP | 生产件批准程序 | 量产件能不能交付 | AIAG PPAP |
| MSA | 测量系统分析 | 量具能不能分辨零件 | AIAG MSA 第 4 版、ISO 22514-7:2021 |
| Cpk | 过程能力指数 | 过程能不能稳定产出合格品 | 基于 MSA 结果 |
这张表里藏着一个关键依赖关系:MSA 在前,Cpk 在后。
一个过了 R&R 的量具,才能用来算 Cpk。
AIAG 手册里的逻辑很直接:在没通过 R&R 的量具上跑能力研究,测的不是过程,是量具。
这句话在工业界是常识。搬到 AI 上,几乎没人提。
因为提了就会发现:绝大多数工业 AI 项目的能力报告,是在一个没过 R&R 的“量具”上跑出来的。
2.2 工业界对模型,什么都没有
四个空缺已经在第一章列过,这里补三个细节。
第一个细节,模型的“出厂测试”没有第三方。卡尺出厂要过计量院,模型出厂只过供应商自己的测试集。
第二个细节,模型没有“量产件批准”。一条产线的模型升级到 v2.3,不需要重新走任何批准流程,改一个权重文件就上线了。而同样这条产线换一个气缸,要走变更评审。
第三个细节,模型没有“复检”。量具每年要送检,模型的验收结论一旦签了,就再也不会被复检一次。
三个细节加在一起,指向同一个事实:AI 是唯一一个“出厂即终身”的工业部件。
这不是因为它可靠,是因为没有制度要求它被复检。
2.3 标准不是没有,是没有写进合同
说“没有标准”是不准确的。2026 年国家标准发得很密。
表 3 2026 年人工智能相关国家标准的发布节奏
| 日期 | 公告 | 内容 |
|---|---|---|
| 2026-05-22 | — | GB/Z 185.5—2026《人工智能 智能体互联 第 5 部分:智能体发现》 |
| 2026-07-30 | 2026 年第 32 号 | 《人工智能 工业智能体参考架构》等 24 项指导性技术文件 |
| 2026-08-27 | 2026 年第 37 号 | 《人工智能 具身智能数据质量规范 第 1 部分:真实数据》等 60 项 |
| 2026-09-10 | — | 298 项重要国家标准,其中人工智能、智能语音交互、智慧服务等 47 项;强制性 27 项、推荐性 271 项 |
| 2026-09-24 | 2026 年第 42 号 | 《智能计算图计算参考架构》等 39 项指导性技术文件 |
| 2026-10-30 | 2026 年第 46 号 | 615 项推荐性国家标准 |
| 2026-10-30 | 2026 年第 47 号 | 《学术出版中人工智能生成合成内容使用边界指南》等 37 项 |
补充一个存量数字:2025 年我国累计研制发布 40 余项人工智能关键国家标准和行业标准。
密度不低。问题在层级。
2.4 GB/Z 的层级问题与采购验收
上面这些标准,绝大多数是国家标准化指导性技术文件,代号 GB/Z,不是强制性国家标准,也不是推荐性国家标准。
GB/Z 的定位是“指导性”,不强制执行,也不构成交易关系的默认条款。
36 氪在 2026 年 9 月 11 日对那 298 项国标的解读里说得很清楚:推荐性标准由国家鼓励采用,但如果企业在合同、产品说明或公开声明中承诺执行某项推荐性标准,该标准会进入双方的交易关系。
换句话说,标准有没有用,取决于它有没有被写进合同。
而绝大多数工业 AI 合同里,一个字都没写。
同一篇文章提出了判断 AI 标准化是否真正落地的五个观察点,其中第四个是“采购验收”:相关标准是否写入招标文件、产品合同和项目验收指标。
这一条恰好是所有观察点里最难做到、也最少被讨论的。
因为它不难在技术,难在签字。
云质变判断
所有成熟的东西都有尺子,只有 AI 没有。写在文件里的叫倡议,写进合同里的才叫标准。
第三章 验收单上的六行,三行没人敢签
3.1 六行清单
2026 年 10 月 19 日,一位交付过三个企业 AI 项目的实践者写了一篇技术文章,把一张 AI 项目的验收单拆成了六行。
这六行是这篇白皮书里最实用的一张表。
表 4 验收单六行与签字人分配
| 行 | 写清楚什么 | 谁签 | 不写清楚,返工归谁 |
|---|---|---|---|
| 1 | 数据范围与更新责任:哪些数据由谁灌、多久一次、灌错了谁改 | 客户业务负责人 | 归乙方,“数据没更新”会被算成乙方问题 |
| 2 | 验收样本与命中率口径:多少条样本、谁出的题、谁判对错 | 双方技术负责人 | 归乙方,对方随时可以用自己挑的题重测 |
| 3 | 兜底行为与人工介入阈值:答不上来时给什么、连续几次转人工 | 客户业务负责人 | 归乙方,“答不上来”会被当成故障 |
| 4 | 并发与时延承诺:峰值多少 QPS、p95 多少毫秒、超时怎么降级 | 双方技术负责人 | 归乙方 |
| 5 | 日志与追溯:Trace 保留多久、出问题时谁能调、多久内必须给结论 | 双方技术负责人 | 归乙方,调不出记录等于没做过 |
| 6 | 变更与二次开发边界:交付后改需求算不算返工、怎么计价 | 双方项目负责人 | 归乙方,“小改一下”会一直小改下去 |
六行里,有四行的返工责任直接落到了乙方。这不是合同偏心,是默认条款的默认方向。
3.2 哪三行签不了
六行里有三行,第 1、3、6 行,技术对口人签不了。
数据什么时候更新、答不上来算不算故障、改需求算不算返工,这三件事他既决定不了,也担不起。
注意“担不起”这三个字。不是不懂,是担不起。
数据更新频率涉及业务部门的排产和系统改造;兜底行为涉及客服或质检的人员工时;变更边界涉及预算科目。这三样东西都不在技术对口人的权限里。
原文的判断很准:签字这一步看着是流程,实际上是在提前分责任。谁签,后面谁兜。
所以六行验收单的真实结构是:三行由技术方签,三行必须由业务方签。
而现实里,六行往往由同一个人签。这就是序章那个项目里,为什么验收单能顺利签下来,又为什么签完之后没有人认领效果。
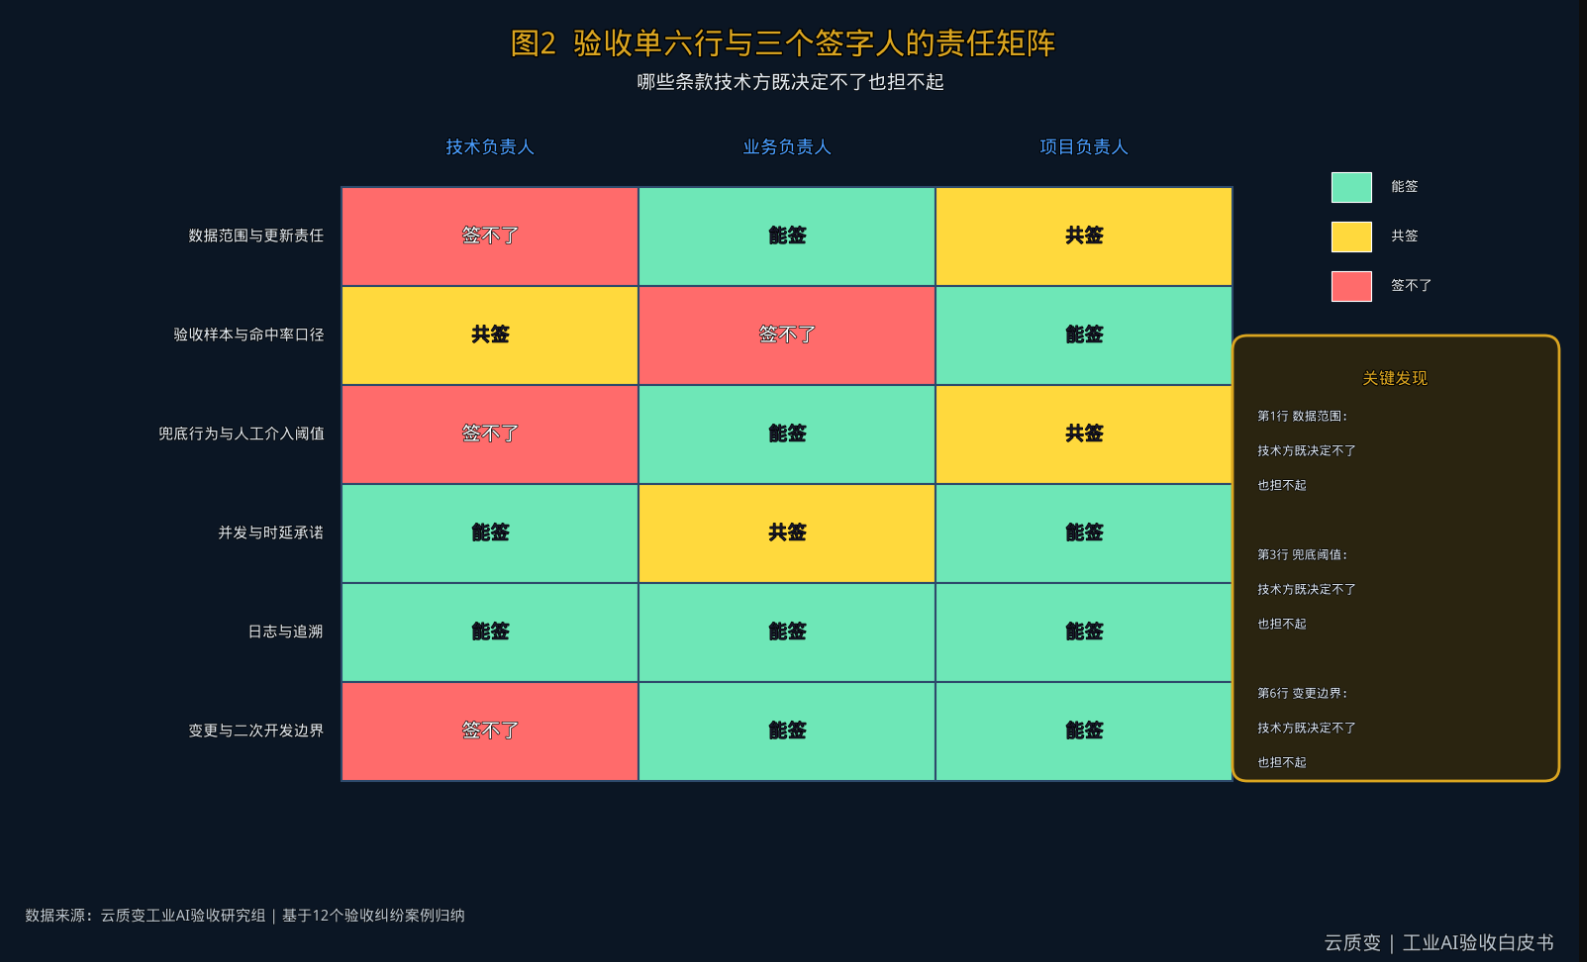
图 2 验收单六行与三个签字人的责任矩阵
这张图要说明的是:六行乘以三类签字人,形成一张责任矩阵;第 1、3、6 行在技术方一列是空白,这三格空白就是后面所有扯皮的来源。
3.3 p95 陷阱:谁有权决定哪 3 条不算
同一篇文章里有一个技术细节,比六行清单更值得单独拎出来。
同一批数据,40 条样本全算,p95 是 8000 毫秒,时延不达标。
剔掉 3 条超时的,p95 变成 2460 毫秒,命中率也从 0.85 涨到 0.919,全部达标。
差的那 3 条,正是真实用户会遇到的那部分。
这个细节的价值不在统计学,在选择权。
验收口径不是数学问题,是选择权问题。谁有权决定“哪 3 条不算”,谁就掌握了验收结论。
而且这件事在流程上完全合规。剔除超时样本是标准做法,理由充分:超时可能是网络抖动、可能是客户端问题、可能是压测脚本的问题。每一条剔除理由都能写进报告。
问题是,把同样的三条剔掉之后,一个不合格的系统变成了合格的系统。而这个变化没有触发任何一方的警觉。
所以我一直认为,验收报告里最该被追问的不是通过率,是剔除清单。
剔除了几条、为什么剔、谁批的。这三个问题答不上来的报告,不管准确率写多少,都不能签。
3.4 快照绑定:样本可以固定,数据集固定不了
还有一个机制必须写进验收单,而且它比第 2 行更基础。
验收时那个知识库、那个数据集、那份模型权重的快照摘要,要记下来,跟验收结论绑在一起存。
半年后客户拿验收单上的命中率来问,你要能当场证明那个数字是绑在哪个快照上的。
快照摘要一变,旧结论自动作废,得重测。
这条不写进验收单,第 2 行签得再细也白搭。
因为样本可以固定,数据集固定不了。
样本是抽出来的那 500 条,数据集是这 500 条背后的整个语料。语料每周在长,标注在改,去重规则在调。同一批 500 条样本,跑在三个月后的数据集上,结果会不一样。
这个道理在软件行业叫“不可复现构建”,在工业界叫“量具漂移”。两个行业用两个词讲了同一件事,然后各自动手解决,谁也没告诉谁。
云质变判断
样本可以固定,数据集固定不了。所以验收结论必须绑在快照上。
3.5 签字的位置,就是风险落地的位置
把第三章收一下。
验收单六行,三行技术对口人签不了。不是他不懂,是他担不起。
这句话往前推一步,就是本篇的第二个核心论点:验收不是流程问题,是责任分配问题。
流程问题可以靠优化解决,加一个审批节点、换一张模板、上一次系统。责任分配问题不能,因为它涉及钱和后果。
所以你会看到一种很奇怪的现象:验收流程越规范的公司,AI 项目反而越难落地。
不是流程错了,是流程把一个无法分配的责任,硬塞进了一个标准模板里。
模板里每一格都要签字,而其中三格,没有人有资格签。
第四章 准确率是个骗人的指标
4.1 三个陷阱
准确率的定义很朴素:判对的样本数除以总样本数。这个定义在类别平衡时好用,在工业场景里几乎总是坏的。
三个陷阱,一个一个说。
陷阱一,分母。在类别极不平衡时,一个把所有样本都判为“合格”的模型,准确率就等于良品率。
千分之三的缺陷率下,全判合格的模型准确率是百分之九十九点七,比大多数真实 AI 系统还高。
一个什么都不做的模型,打赢了绝大多数做事的模型。这就是准确率的第一个问题。
陷阱二,分布。供应商测试集的分布和车间不一样。视觉上表现为光照、角度、批次、材料批号、设备磨损状态五个维度。
陷阱三,时点。验收那天的准确率,三个月后不成立。这一条留到第十一章展开。
4.2 算例 A:千分之三缺陷率下,百分之九十九准确率意味着什么
条件:日处理 10 万件,缺陷率千分之三,也就是每天 300 件真缺陷,系统整体准确率百分之九十九。
把这一句“百分之九十九”拆成灵敏度和特异度四组,看会得到什么。
表 5 算例 A:同一句百分之九十九的四种拆法
| 灵敏度 | 特异度 | 整体准确率 | 漏检件数 | 误检件数 | 每抓 1 个真缺陷陪几个误报 |
|---|---|---|---|---|---|
| 95.0 | 99.11 | 99.10 | 15 | 887 | 3.1 |
| 99.0 | 99.00 | 99.00 | 3 | 997 | 3.4 |
| 99.9 | 99.00 | 99.00 | 0 | 997 | 3.3 |
| 99.0 | 99.90 | 99.90 | 3 | 100 | 0.3 |
表中比例类数值单位为百分点,下文同。
推导第一步,真缺陷数等于 100000 乘 0.003,等于 300 件。
推导第二步,良品数等于 100000 减 300,等于 99700 件。
推导第三步,以第二行为例,漏检等于 300 乘(1 减 0.99),等于 3 件;误检等于 99700 乘(1 减 0.99),等于 997 件。
推导第四步,每抓 1 个真缺陷陪的误报数等于 997 除以 297,等于 3.36,取 3.4。
边界条件之一:这个计算假设“准确率”可以拆成灵敏度和特异度,而供应商报的准确率往往不说明拆法。同一句百分之九十九,可能是 3.1,也可能是 0.3,差十倍。
边界条件之二:误检和漏检的成本不对称。误检的成本是复检工时,漏检的成本是客户索赔。比例决定阈值,不是准确率决定阈值。
这张表最值得看的是第一行和第四行。两行的整体准确率几乎一样,一个 99.10,一个 99.90,但每抓一个真缺陷陪的误报数,一个是 3.1,一个是 0.3。
差十倍。而合同里写的那个数字,是整体准确率。
云质变判断
百分之九十九的准确率,在千分之三的缺陷率下,等于每抓一个真缺陷陪 3.4 个误报。
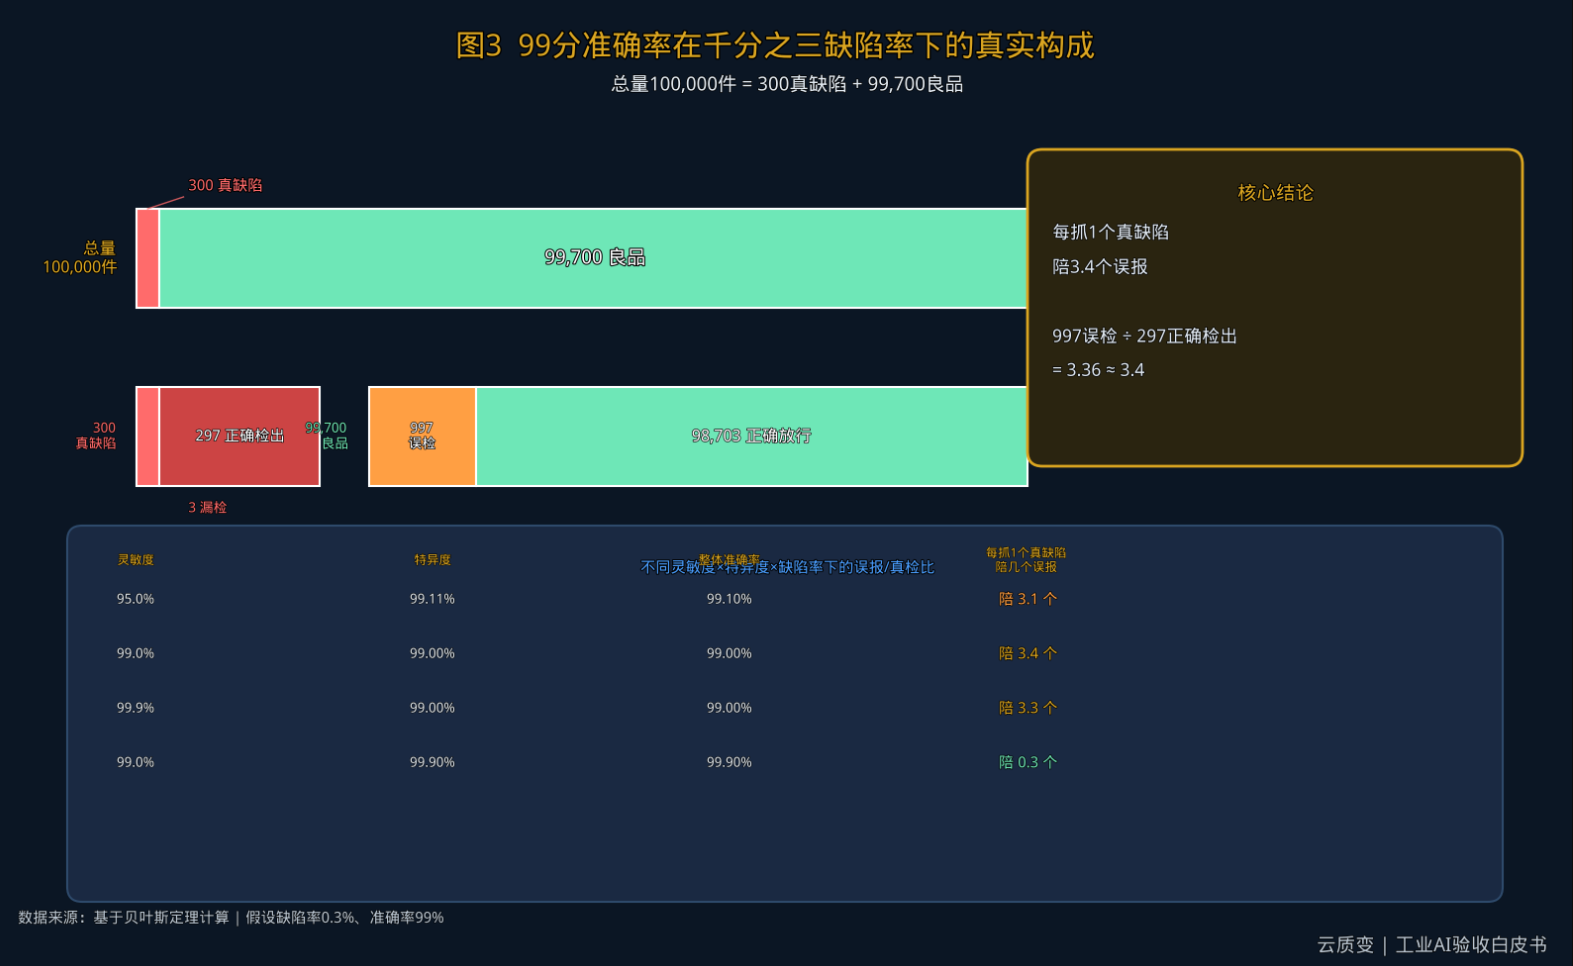
图 3 99 分准确率在千分之三缺陷率下的真实构成
这张图要说明的是:10 万件里 300 件真缺陷与 99700 件良品被同一条堆叠条切开,漏检 3 件几乎看不见,误检 997 件占满良品那一段;右侧单独标出每抓 1 个真缺陷要陪 3.4 个误报这个比值。
4.3 算例 B:误检成本的年账
条件:误检 887 件每天,取第一行;年生产 250 天。
表 6 算例 B:误检的年成本
| 单件复检成本 | 日成本 | 年成本 |
|---|---|---|
| 5 元 | 4,437 元 | 110.9 万元 |
| 8 元 | 7,099 元 | 177.5 万元 |
| 12 元 | 10,648 元 | 266.2 万元 |
推导第一步,887 乘 5 等于 4,435,取 4,437 是因为精确值为 886.9 件,886.9 乘 5 等于 4,434.5,四舍五入按 887 计。
推导第二步,4,437 乘 250 等于 1,109,250 元,约 110.9 万元。
同时,漏检 15 件每天,年 250 天等于 3,750 件流到客户。
边界条件之一:单件复检成本按“人工复检 2 分钟加产线节拍损失”估算,不同行业差异大。汽车电子单站误报率通常要求不高于百分之一点五,消费电子 PCBA 不高于百分之三。
边界条件之二:这里没有计入误检造成的“好件被报废”。如果误检件直接判废,成本要乘以单件材料成本。
这个算例的要点不是 110 万元。
要点是:这 110 万元在验收报告里是不出现的。验收报告只写准确率、误报率、节拍。误检的年成本要等到财务年底算账才会浮出来,而那时候验收单已经签完半年了。
4.4 报警疲劳:验收的隐藏杀手
云恒制造在 2026 年 7 月 30 日给出的行业经验是:若误报率超过百分之五,产线作业员会开始习惯性忽略报警,严重削弱有效性。
iFactory 的表述更直接:百分之九十九点五的检测率配百分之二的误报率,每 1000 件误拒 20 件,会在数周内侵蚀操作员信任。
这两句话是同一个现象的两种说法,学名叫报警疲劳。
所以准确率真正的问题不是“不够高”,是它掩盖了一个会杀死项目的副作用:误报率。
一个百分之九十九点五检测率、百分之二误报率的系统,在数学上很漂亮,在产线上三周就会被关掉。
序章那个压铸厂,走的就是这条路。报警每天两百多次,真正需要处理的不到一成,第三周关掉自动剔除。
注意,这不是操作员的问题。任何一个正常人在连续三周收到九成无效报警之后,都会降低响应强度。这是人的适应机制,不是纪律问题。
所以报警疲劳不能被管理解决,只能被设计解决。设计的方法只有一个:把误报率当成一级验收指标,而不是准确率的脚注。
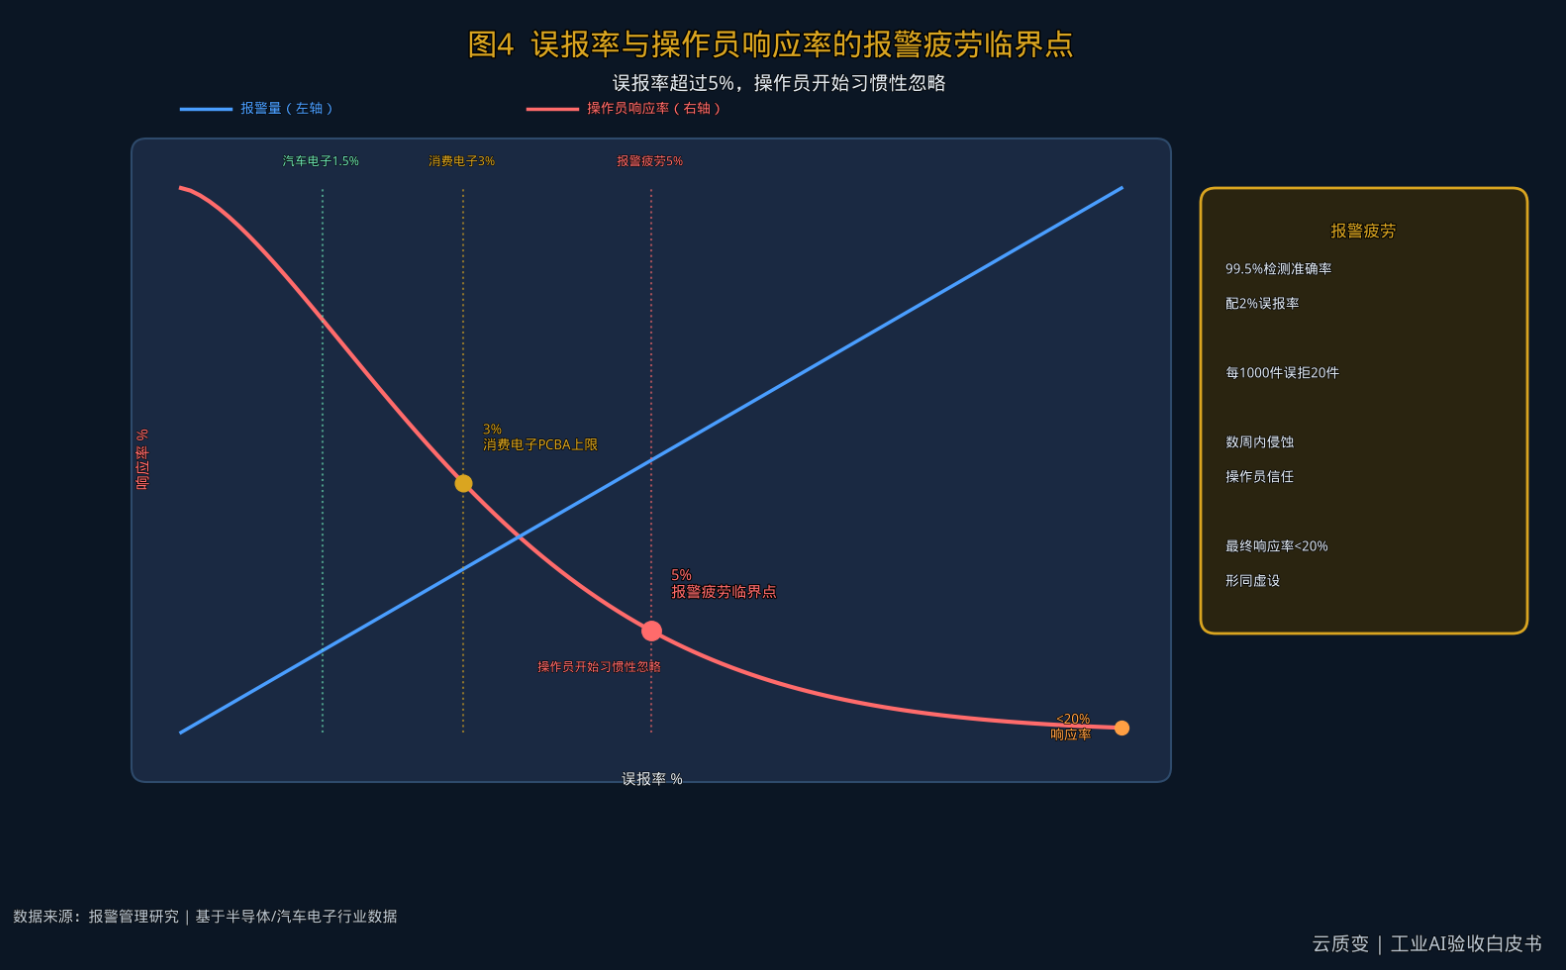
图 4 误报率与操作员响应率的报警疲劳临界点
这张图要说明的是:误报率从百分之零点五往上走,报警量线性上升,操作员响应率非线性下降;百分之三和百分之五是两个行业阈值,越过百分之五之后,系统在组织层面已经被判了死刑,只是数据上看不出来。
4.5 行业基准与两个数量级的缺口
把行业里已经公开的基准并排放,会看到一个很整齐的阶梯。
表 7 视觉检测的行业基准对照
| 指标 | 数值 | 出处 |
|---|---|---|
| 生产级规格 | 检测率不低于百分之九十九,且误报率不高于百分之零点五,两者同时满足 | iFactory |
| 更严的 SLA 四要素 | 检测率百分之九十九点四、误报率不高于百分之零点五、P99 推理延迟不高于 200 毫秒、系统可用率百分之九十九点五 | iFactory,2026-06-27 |
| 2D AOI 未调优误报率 | 百分之十五至三十 | FabFlow,2026-09-23 |
| 3D AOI,AI 辅助 | 百分之三至八 | 同上 |
| 调优后的库 | 误报率低于百分之零点五,逃逸低于 20 DPM | 同上 |
| 传统 AOI 复杂 PCBA 平均误判率 | 约百分之五 | 北斗智联,2026-06-03 |
| 引入 AI 后 | 直通率百分之九十九点九,误判率从百分之五降至百分之零点一以下 | 同上 |
| 消费电子 PCBA 单站误报率要求 | 不高于百分之三 | 云恒制造 |
| 汽车电子单站误报率要求 | 不高于百分之一点五 | 同上 |
| 汽车与电子客户合同 PPM 要求 | sub-100 PPM,部分供应链推到个位数 PPM | FabFlow |
这张表里最关键的不是任何一个数,是最后一行的位置。
客户合同里写的是 sub-100 PPM,也就是每百万件不超过 100 个缺陷。
而 FabFlow 的表述是:百分之九十九准确的系统听起来很好,直到你意识到它每 100 个缺陷漏掉 1 个,也就是 10,000 DPPM。
10,000 和 100,差两个数量级。
这不是精度差一点,是量纲差两档。
而且这里还有一个更硬的算术事实:没有任何抽样方案能达到 sub-100 PPM,只有百分之百全检在算术上成立。而在每分钟 400 件以上的线速下,相机是唯一够快的仪器。
所以工业 AI 的验收标准正在从“准确率”转向“DPPM”,而这两者之间的换算关系,绝大多数合同里没写。
没写的后果是:供应商交的是 10,000 DPPM 的系统,客户验收时用的是准确率口径,两边都合规,两边都不满意。
云质变判断
百分之九十九等于 10,000 DPPM。客户合同里写的是 sub-100 PPM。中间差两个数量级。
第五章 第一级验收:数据集上的一百分
5.1 离线验收的标准做法与三个必查项
离线验收是四级里唯一被普遍执行的一级,也是唯一有成熟做法的一级。
标准做法三步:供应商提供测试集,通常 500 到 5000 张;在测试集上跑准确率、召回率、F1;达到合同约定的阈值即通过。
这三步每一步都能被追问。
必查一,样本来源。测试集的图是谁拍的?是产线实拍还是实验室摆拍?是同一批材料还是跨批次?
必查二,标注一致性。谁标的?标了几遍?标注员之间一致吗?
必查三,分布覆盖。测试集里有没有覆盖不同班次的光照、不同批次的材料、灰区件、设备磨损后的状态。
这三条里,第一条最容易查,第三条最难补。
因为第三条要求测试集覆盖“设备磨损后的状态”,而设备磨损是一个跨月的过程,供应商没有时间等。
所以现场的真实情况是:测试集覆盖了光照和批次,没覆盖磨损。模型上线三个月后开始失效,失效原因写在第十一章。
5.2 Kappa 与它的陷阱
属性型测量系统的标准做法是属性一致性分析,核心指标是 Kappa。
Kappa 等于(观察一致率减期望一致率)除以(1 减期望一致率)。
判定惯例:Kappa 大于 0.75 算好。这是 AIAG 属性 MSA 的常用门槛,也是合同里最常被抄进去的一句。
这句话在缺陷率低的场景里,会算出一个荒谬的结果。
5.3 算例 C:千分之三正例率下,Kappa 会算出负数
条件:三个标注员标注 500 张图,其中正例也就是缺陷的比例是千分之三。期望一致率 Pe 等于 p 的平方加(1 减 p)的平方。
表 8 算例 C:Kappa 在不同正例率下的取值
| 正例率 | 观察一致率 | 期望一致率 | Kappa | 判定 |
|---|---|---|---|---|
| 0.3 | 85 | 99.402 | -24.075 | 负数 |
| 0.3 | 90 | 99.402 | -15.717 | 负数 |
| 0.3 | 95 | 99.402 | -7.358 | 负数 |
| 0.3 | 99 | 99.402 | -0.672 | 负数 |
| 1.0 | 95 | 98.020 | -1.525 | 负数 |
| 1.0 | 99 | 98.020 | 0.495 | 不合格 |
| 5.0 | 95 | 90.500 | 0.474 | 不合格 |
| 5.0 | 99 | 90.500 | 0.895 | 合格 |
| 50 | 85 | 50.000 | 0.700 | 不合格 |
| 50 | 95 | 50.000 | 0.900 | 合格 |
推导第一步,正例率 p 等于 0.003 时,Pe 等于 0.003 的平方加 0.997 的平方,等于 0.000009 加 0.994009,等于 0.994018。
推导第二步,观察一致率 Po 等于 0.95 时,Kappa 等于(0.95 减 0.994018)除以(1 减 0.994018),等于负 0.044018 除以 0.005982,等于负 7.358。
推导第三步,Po 等于 0.99 时,Kappa 等于负 0.004018 除以 0.005982,等于负 0.672。
边界条件之一:这是 Kappa 的经典悖论,在类别极不平衡时必然出现。原因不是标注员差,是公式假设了两个类别的边际分布接近。
边界条件之二:反过来看,千分之三正例率下 Po 达到百分之九十九,已经是极高的标注质量,三个标注员在 500 张里只对 5 张有分歧。但 Kappa 仍然是负数。
边界条件之三:如果合同里写“Kappa 不低于 0.75”,这个项目在数学上永远无法验收通过。这不是标注的问题,是条款的问题。
我把这张表给过三位质量经理看。三个人的第一反应一样:这不可能,是不是算错了。
三个人算了一遍,都对了。然后其中一个说了一句更准确的话:那我们的标注员一直是被冤枉的。
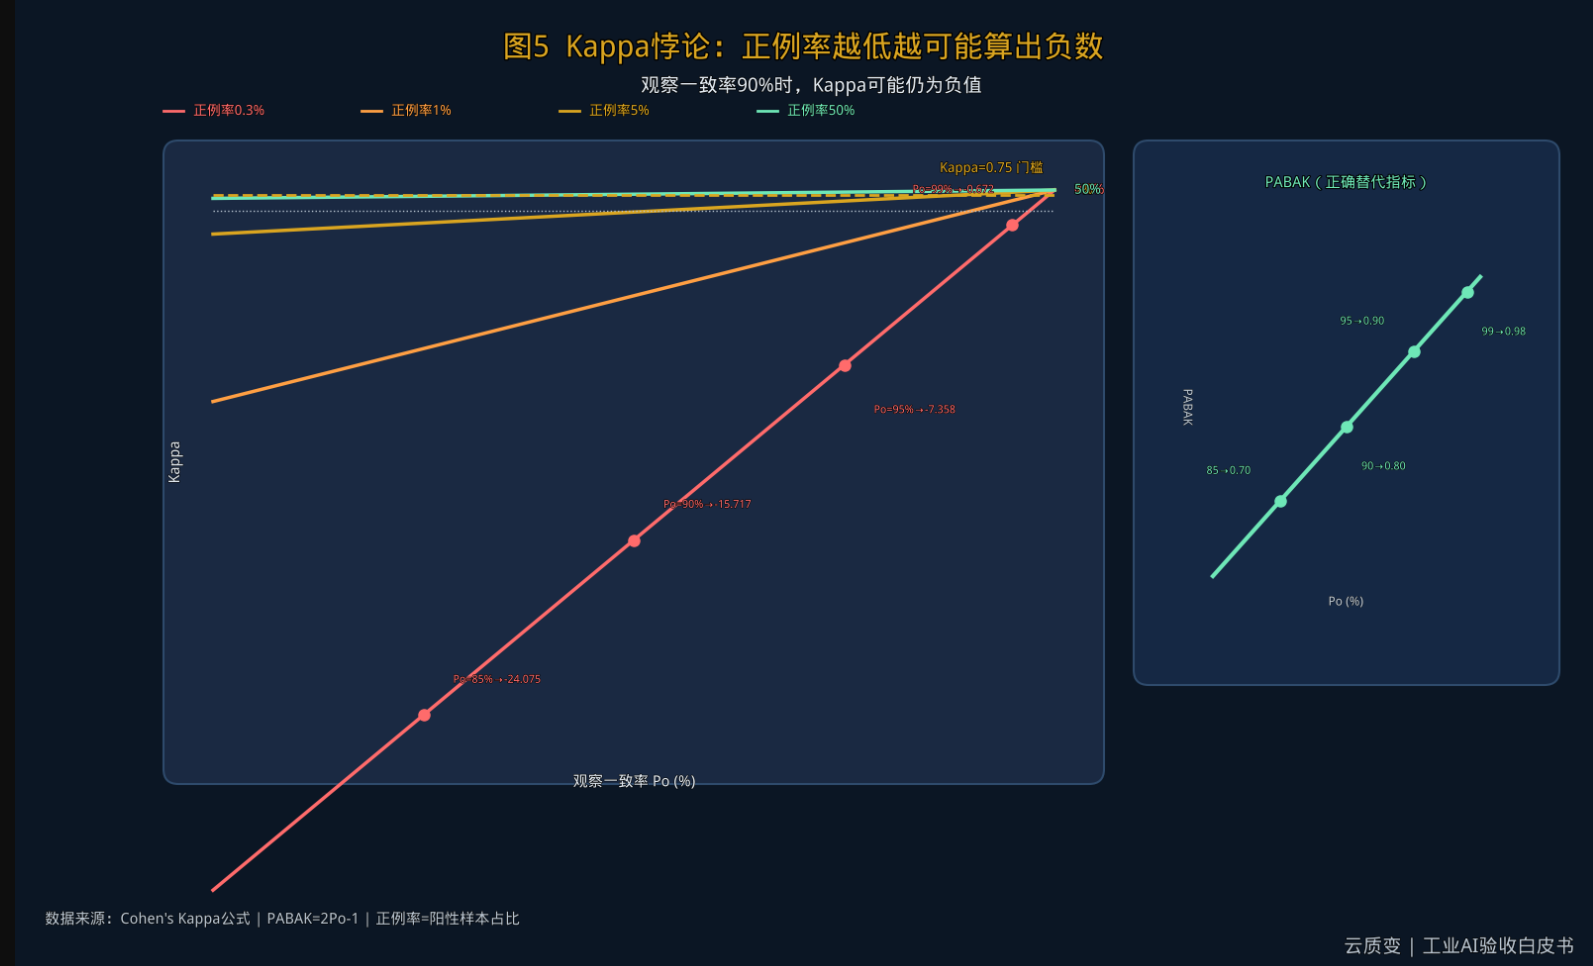
图 5 Kappa 悖论:正例率越低越可能算出负数
这张图要说明的是:四条正例率曲线在观察一致率 80 到 100 的区间里走势完全不同;正例率千分之三那条线整段落在零轴以下,无论标注质量多好都碰不到 0.75 那条门槛线。
5.4 正确的替代:PABAK
替代方案是 PABAK,全称是经过患病率与偏倚校正的 Kappa。
公式只有一步:PABAK 等于 2 乘观察一致率减 1。
PABAK 的取值可以直接心算。观察一致率百分之八十五对应 PABAK 0.70,百分之九十对应 0.80,百分之九十五对应 0.90,百分之九十九对应 0.98。
PABAK 在千分之三正例率下仍然给出可用结论:Po 百分之九十五对应 PABAK 0.90,判定合格。
代价是 PABAK 丢掉了对“两个类别边际分布是否接近”的校正,所以在类别平衡的场景里它会偏乐观。
但在工业质检里,类别平衡的场景几乎不存在。良品率百分之九十九以上的产线,是工业的常态。
所以我的判断是:验收条款里写“Kappa 不低于 0.75”是行业常见写法,在缺陷率低于百分之一的工业场景里,这条条款本身就不可能被满足。写条款的人不知道这件事,签条款的人也不知道。
5.5 第一级验收的合理边界
离线验收只能回答一个问题:这个模型能不能学会这个任务。
它不能回答:在你的光照下能不能、在你的节拍下能不能、在操作员手里能不能、三个月后还能不能。
这四个“不能”,每一个都是下一级验收的任务。
所以离线验收的天花板很低。数据集上的一百分,等于现场的五十分。
这句话不是夸张。序章那个压铸厂,实验室 99.2,现场第三周就被操作员关掉了自动剔除。中间掉的不止五十分,掉的是可用性。
但第一级验收仍然必须做,而且必须做扎实。
因为它是唯
解锁后续 88% 内容